Windows)Python)写真「顔検出+AI輪郭抽出+AI自動シミ消し+美肌効果」アプリ作成。
Pythonで、写真の人物を美肌に編集加工するWindowsアプリなどを作成してきた。
AIによる顔検出+AI輪郭抽出も行った。

写真のオブジェクト除去も作成した。シミ消しにも使える。

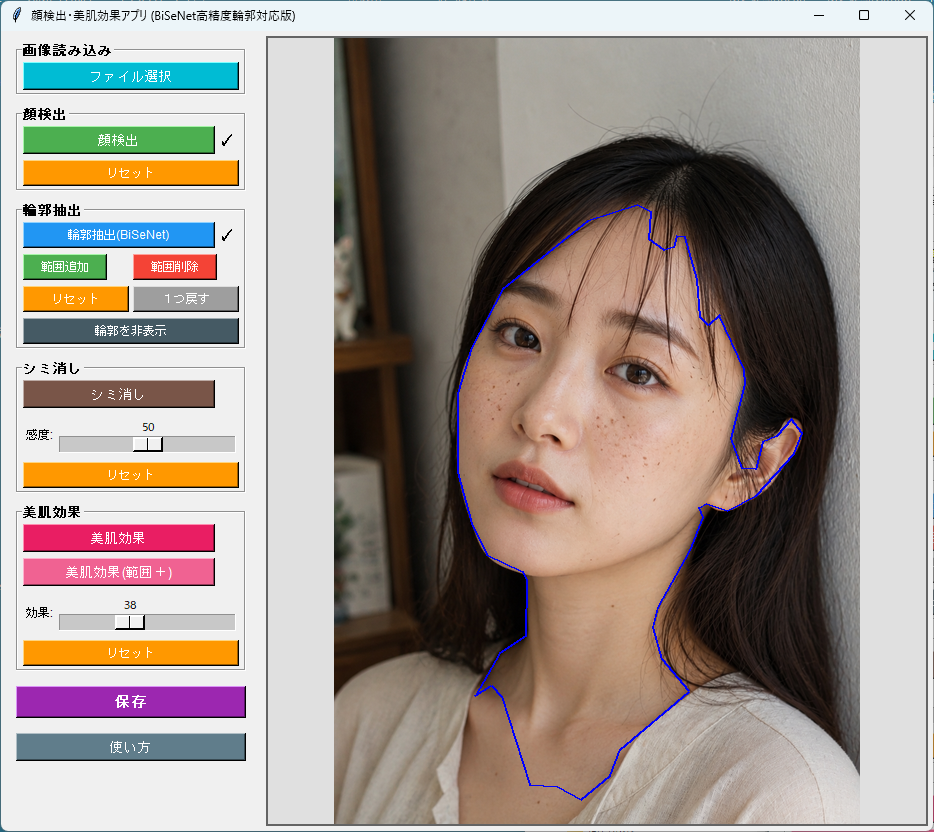
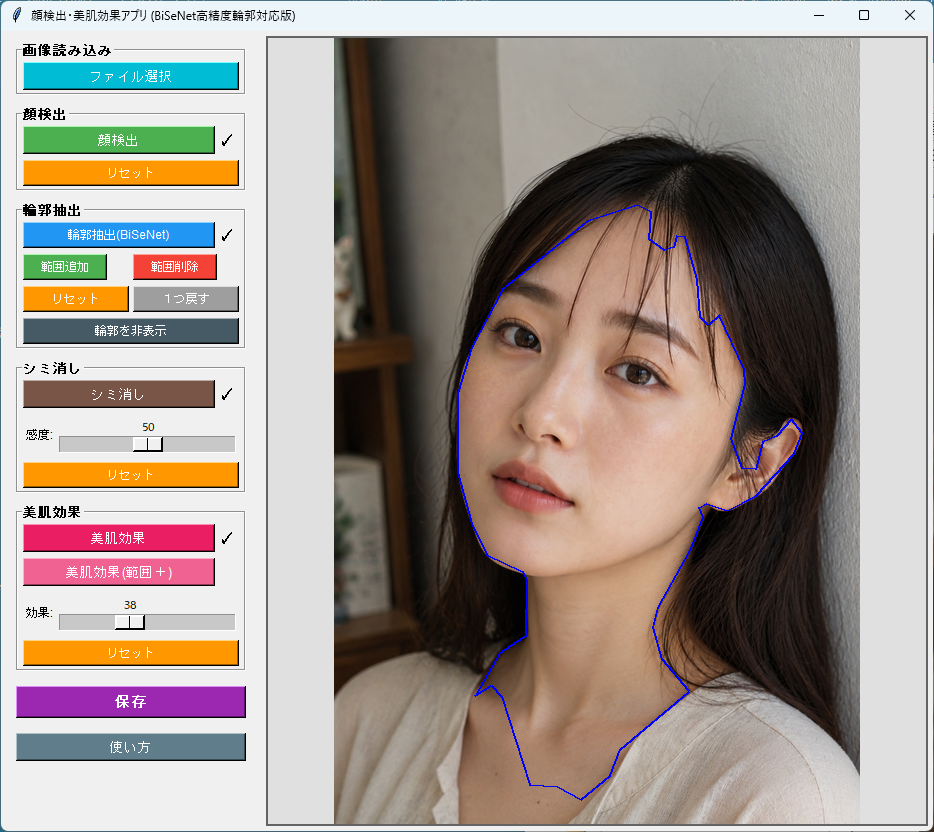
今回、「顔検出+AI輪郭抽出+美肌効果」アプリに、「AI自動シミ消し」機能を追加した。輪郭範囲内のシミをAIが判断して除去する。シミ消しは、感度を指定できる。
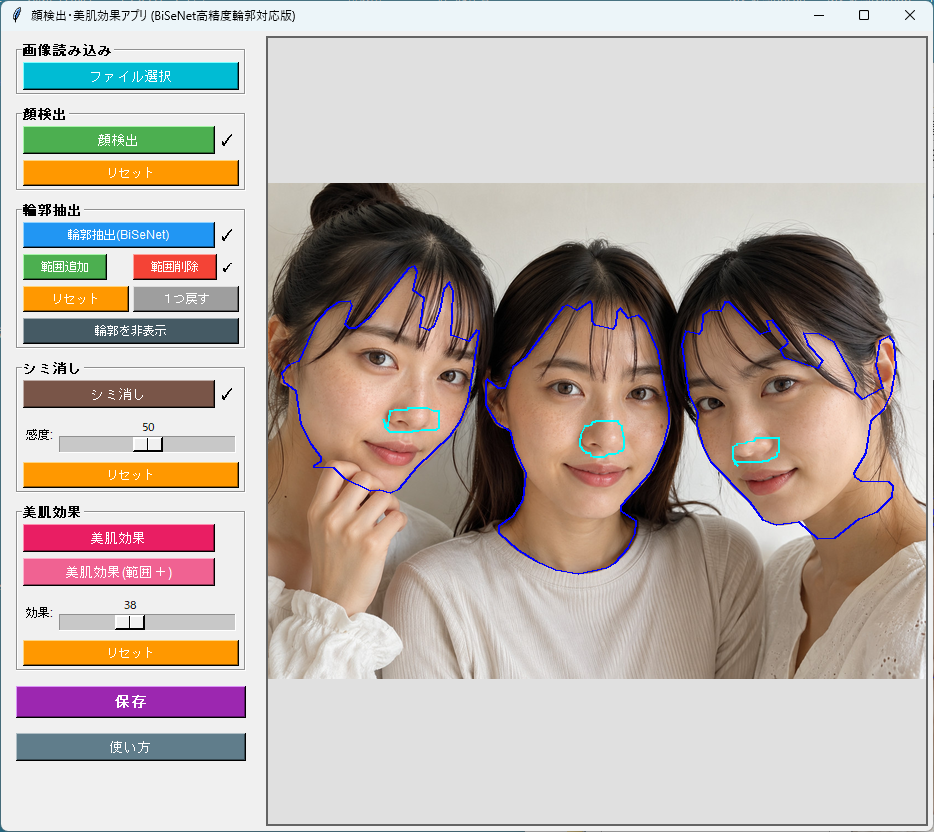
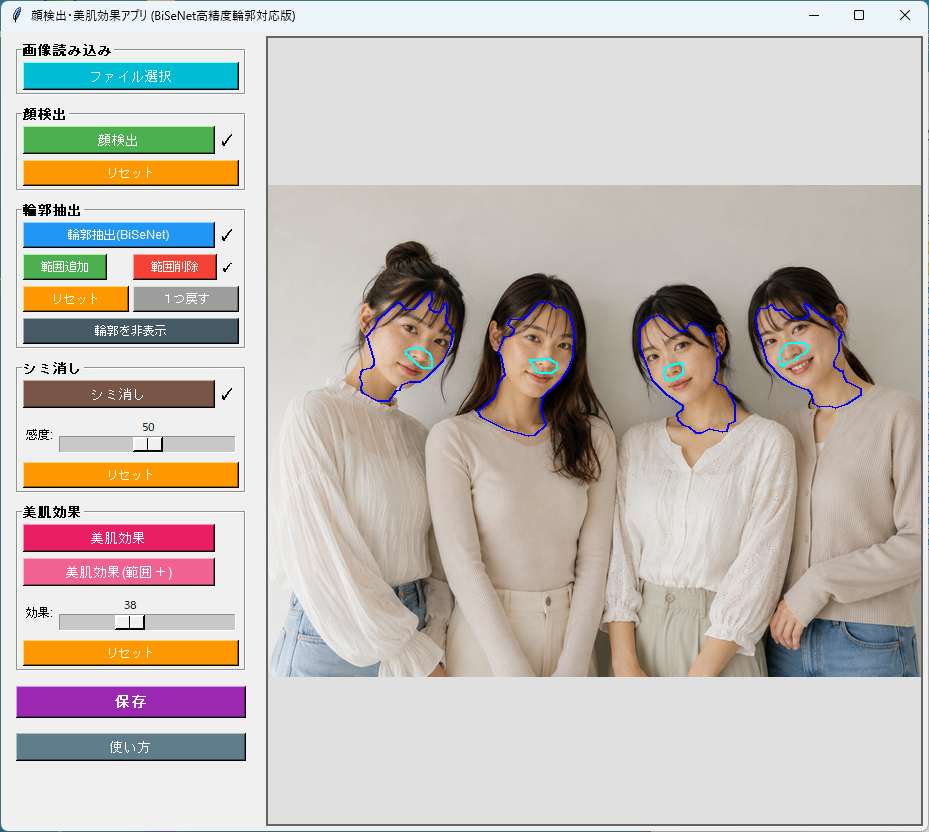
※ 現時点では、人物の顔面積が小さいと鼻の穴がシミと認識されて消えたりすることもある。改善を試みたが、別の影響が出るなどして難しい。人物の顔面積が小さい時は、輪郭抽出で鼻の穴や耳などは輪郭範囲から除外した方が良いかも。それ以外にも細い髪の毛が消えたり、顔の輪郭周辺に影が出ることも。
輪郭抽出についても、方式を変更し、精度と速度を向上させた。輪郭範囲を中抜けで除外できるようにもした。輪郭範囲を非表示にもできるようにした。
【顔検出】

【輪郭抽出】
人物の顔面積が小さいと鼻の穴がシミと認識されて消えたりすることもある。人物の顔面積が小さい時は、輪郭抽出で鼻の穴や耳などは輪郭範囲から除外した方が良いかも。
【シミ消し】

【美肌効果】
【オリジナル画像(ChatGPT生成画像)】
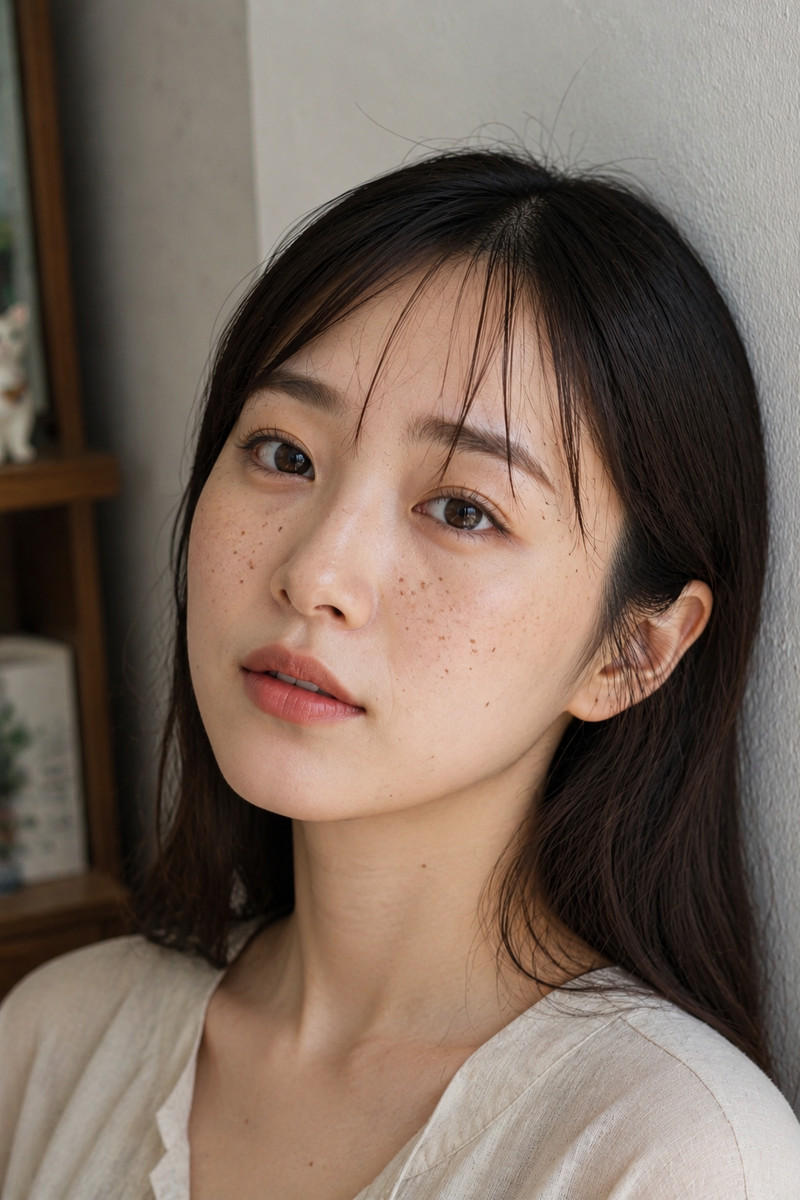
【シミ消しサンプル画像】
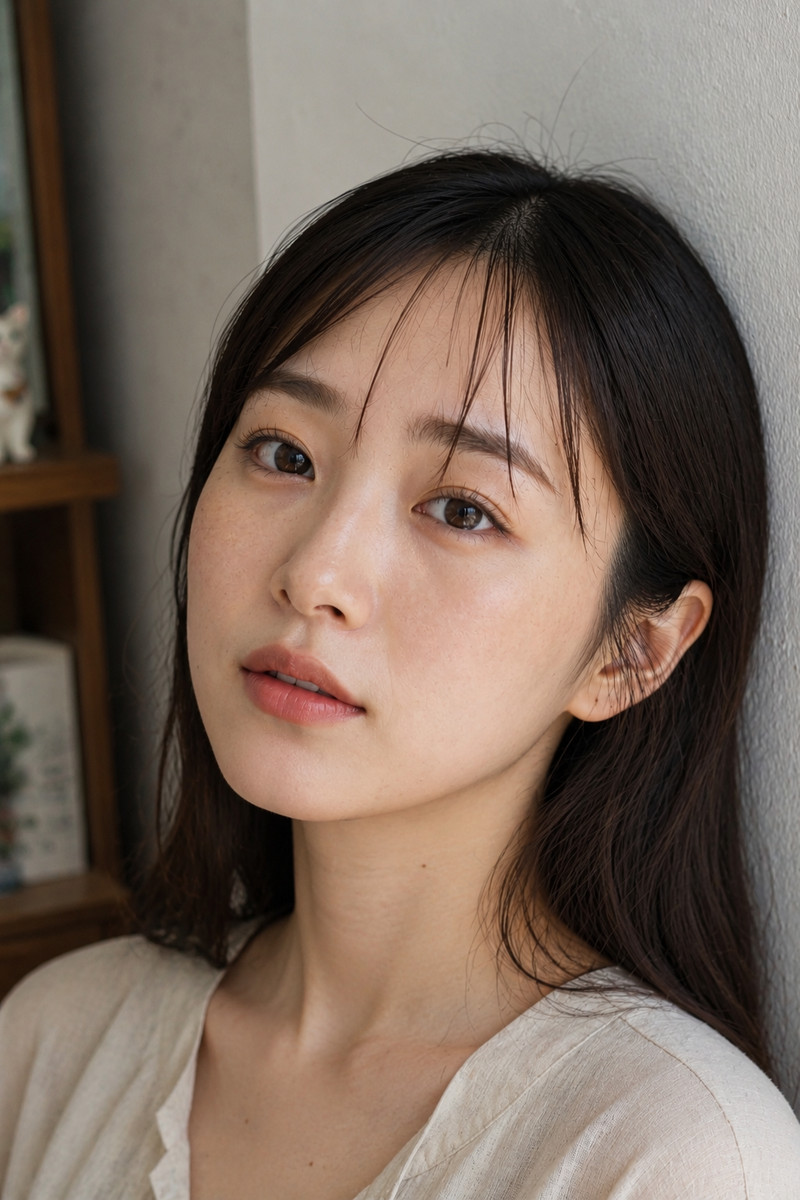
【シミ消し+美肌効果サンプル画像】
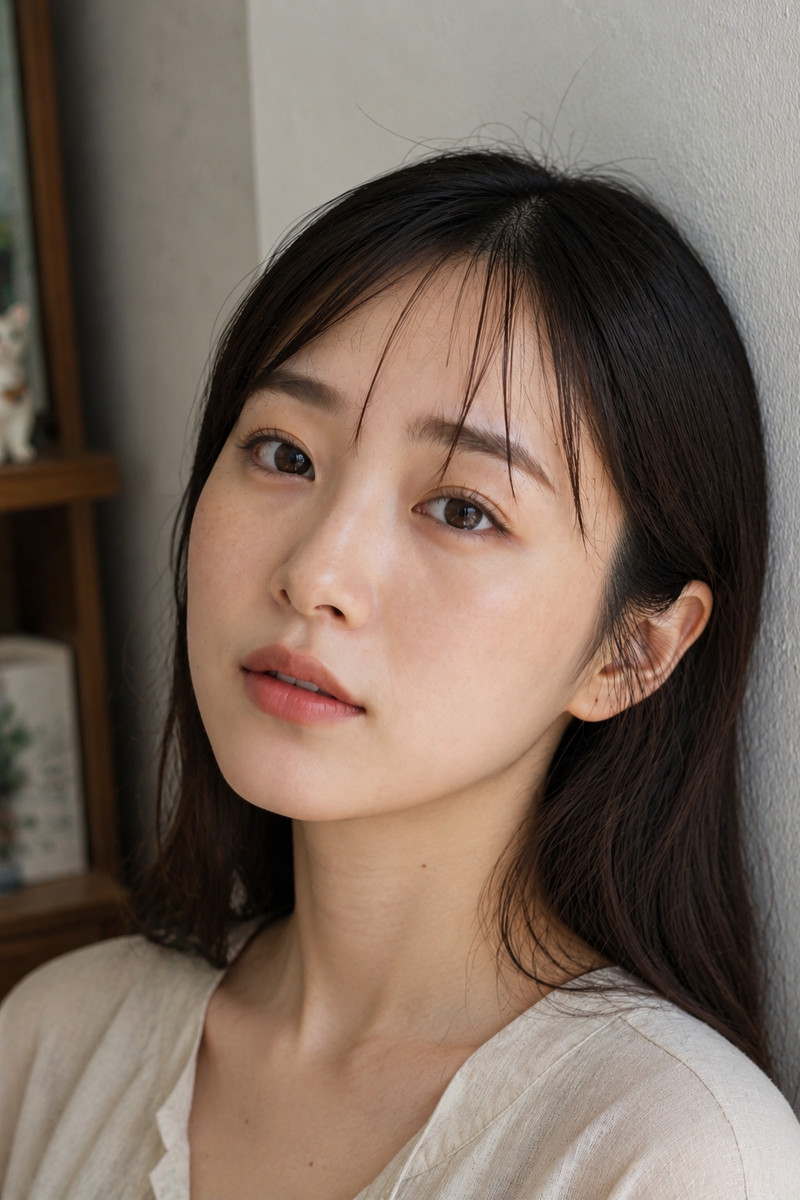
【オリジナル画像(ChatGPT生成画像)】
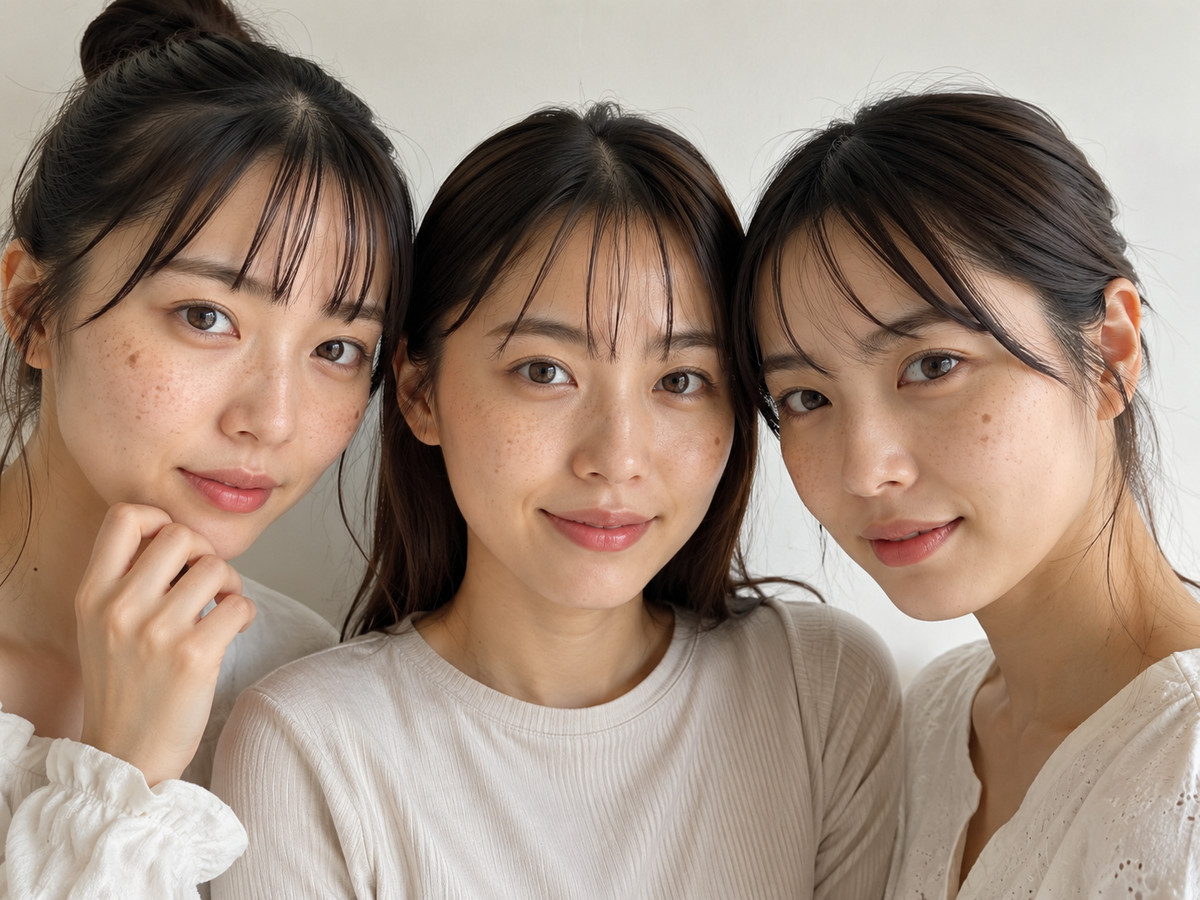
【シミ消しサンプル画像】
※ 鼻の穴は、シミ消し対象範囲から除外指定した。
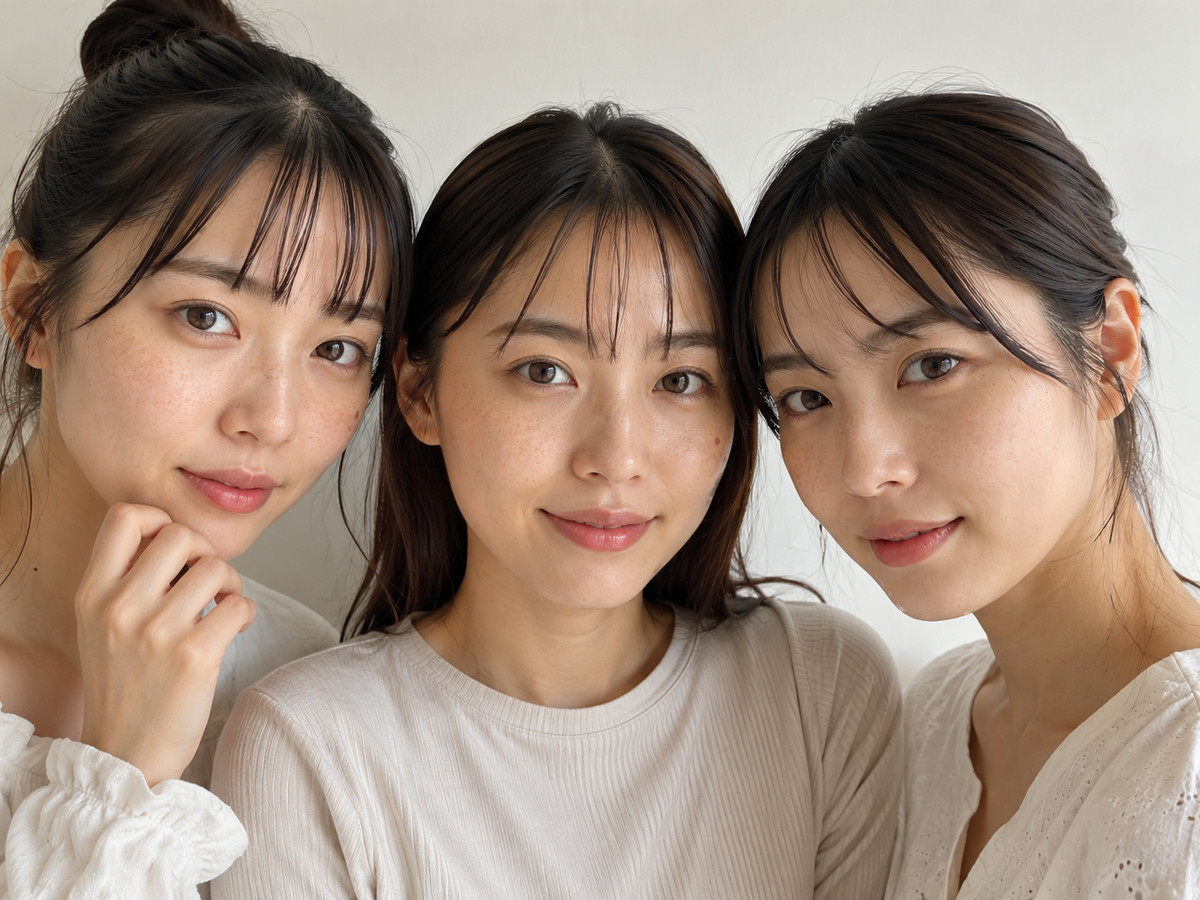
【オリジナル画像(ChatGPT生成画像)】
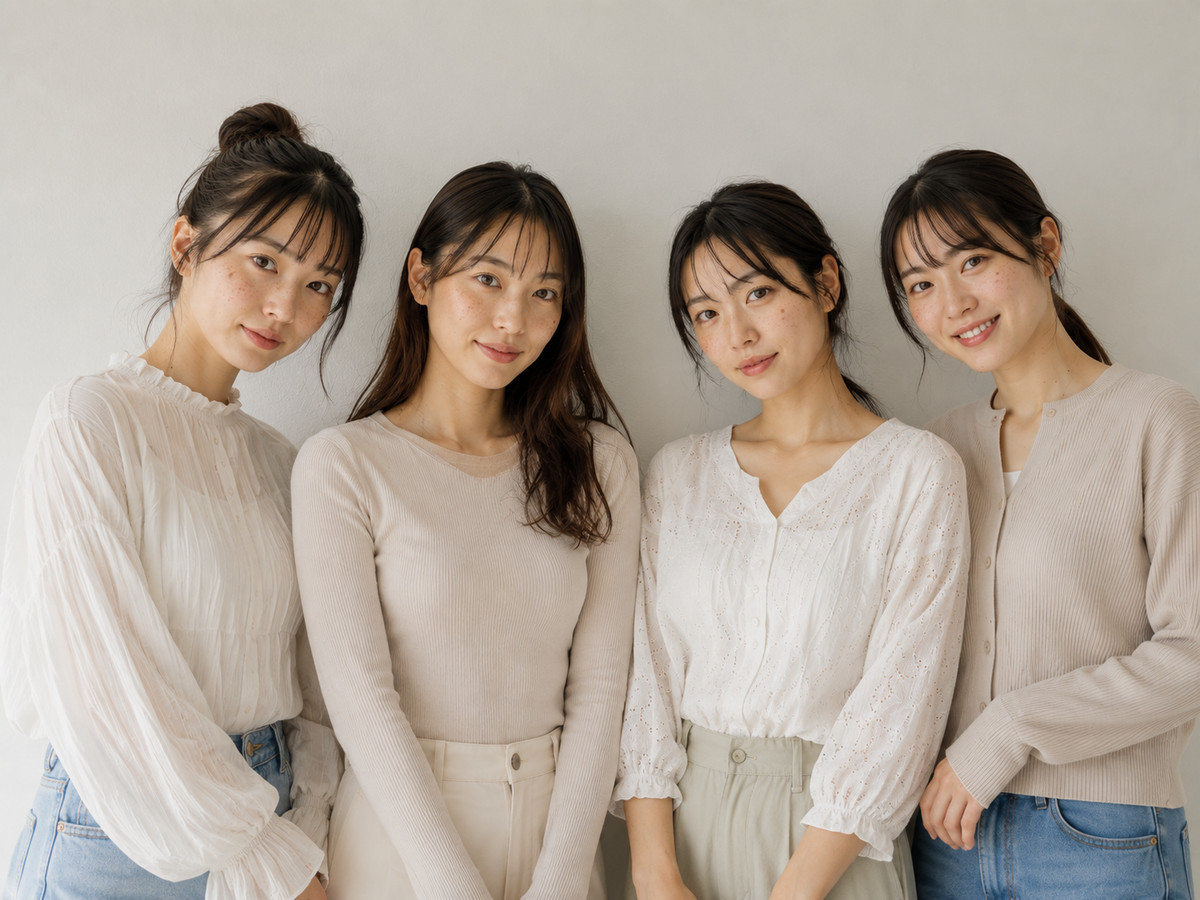
【シミ消しサンプル画像】
※ 鼻の穴や耳は、シミ消し対象範囲から除外指定した。
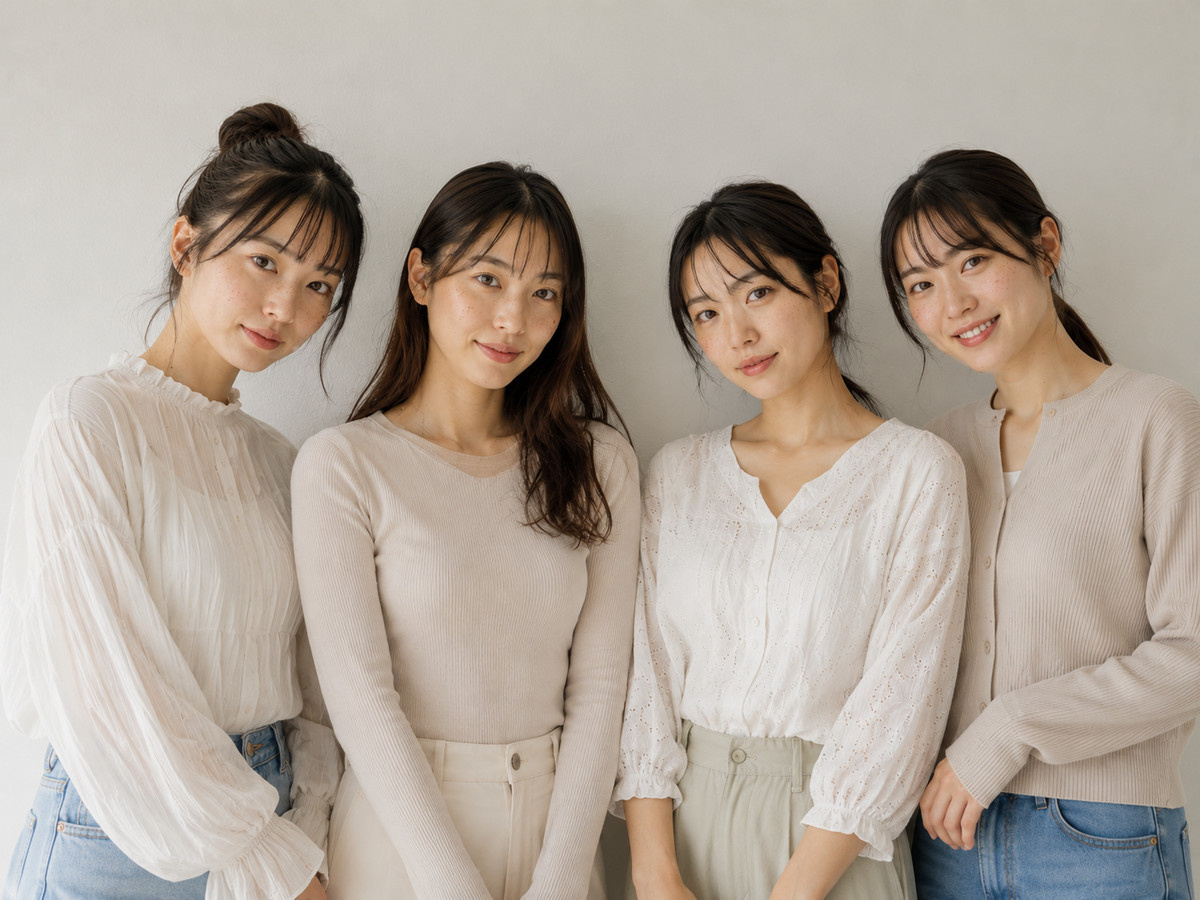
【Pythonプログラムソースコード(輪郭抽出精度改善版)】
import tkinter as tk
from tkinter import ttk, filedialog, messagebox
from PIL import Image, ImageTk, ImageDraw, ImageFilter
import cv2
import numpy as np
import mediapipe as mp
import os
import sys
import io
import threading
# ── BiSeNet 用 ──────────────────────────────────────────────────────────────
try:
import torch
import torch.nn as nn
import torch.nn.functional as F
import torchvision.models as tv_models
TORCH_AVAILABLE = True
except ImportError:
TORCH_AVAILABLE = False
# BiSeNet 事前学習済みモデルのキャッシュパス
BISENET_MODEL_PATH = os.path.join(
os.path.expanduser('~'), '.cache', 'face_parsing', '79999_iter.pth')
# Google Drive ファイルID(face-parsing.PyTorch 公式チェックポイント)
BISENET_GDRIVE_ID = '154JgKpzCPW82qINcVieuPH3fZ2e0P812'
if TORCH_AVAILABLE:
# ── BiSeNet アーキテクチャ (zllrunning/face-parsing.PyTorch 公式完全準拠) ─
# 公式リポジトリ: https://github.com/zllrunning/face-parsing.PyTorch
# 79999_iter.pth の state_dict キー名に完全一致させる
class ConvBNReLU(nn.Module):
def __init__(self, in_chan, out_chan, ks=3, stride=1, padding=1):
super().__init__()
self.conv = nn.Conv2d(in_chan, out_chan, kernel_size=ks,
stride=stride, padding=padding, bias=False)
self.bn = nn.BatchNorm2d(out_chan)
def forward(self, x):
return F.relu(self.bn(self.conv(x)))
class BiSeNetOutput(nn.Module):
def __init__(self, in_chan, mid_chan, n_classes):
super().__init__()
self.conv = ConvBNReLU(in_chan, mid_chan, ks=3, stride=1, padding=1)
self.conv_out = nn.Conv2d(mid_chan, n_classes, kernel_size=1, bias=False)
def forward(self, x):
return self.conv_out(self.conv(x))
class AttentionRefinementModule(nn.Module):
def __init__(self, in_chan, out_chan):
super().__init__()
self.conv = ConvBNReLU(in_chan, out_chan, ks=3, stride=1, padding=1)
self.conv_atten = nn.Conv2d(out_chan, out_chan, kernel_size=1, bias=False)
self.bn_atten = nn.BatchNorm2d(out_chan)
self.sigmoid_atten = nn.Sigmoid()
def forward(self, x):
feat = self.conv(x)
atten = F.avg_pool2d(feat, feat.size()[2:])
atten = self.conv_atten(atten)
atten = self.bn_atten(atten)
atten = self.sigmoid_atten(atten)
return torch.mul(feat, atten)
class FeatureFusionModule(nn.Module):
def __init__(self, in_chan, out_chan):
super().__init__()
self.convblk = ConvBNReLU(in_chan, out_chan, ks=1, stride=1, padding=0)
self.conv1 = nn.Conv2d(out_chan, out_chan // 4, kernel_size=1, bias=False)
self.conv2 = nn.Conv2d(out_chan // 4, out_chan, kernel_size=1, bias=False)
self.relu = nn.ReLU(inplace=True)
self.sigmoid = nn.Sigmoid()
def forward(self, fsp, fcp):
fcat = torch.cat([fsp, fcp], dim=1)
feat = self.convblk(fcat)
atten = F.avg_pool2d(feat, feat.size()[2:])
atten = self.conv1(atten)
atten = self.relu(atten)
atten = self.conv2(atten)
atten = self.sigmoid(atten)
feat_atten = torch.mul(feat, atten)
return feat + feat_atten
class _Resnet18(nn.Module):
"""公式の resnet.py Resnet18 クラスに準拠 (state_dict キー: cp.resnet.*)"""
def __init__(self):
super().__init__()
r = tv_models.resnet18(weights=None)
self.conv1 = r.conv1
self.bn1 = r.bn1
self.relu = r.relu
self.maxpool = r.maxpool
self.layer1 = r.layer1
self.layer2 = r.layer2
self.layer3 = r.layer3
self.layer4 = r.layer4
def forward(self, x):
x = self.conv1(x)
x = self.bn1(x)
x = self.relu(x)
x = self.maxpool(x)
x = self.layer1(x)
feat8 = self.layer2(x) # stride=8, ch=128
feat16 = self.layer3(feat8) # stride=16, ch=256
feat32 = self.layer4(feat16) # stride=32, ch=512
return feat8, feat16, feat32
class ContextPath(nn.Module):
def __init__(self):
super().__init__()
self.resnet = _Resnet18()
self.arm16 = AttentionRefinementModule(256, 128)
self.arm32 = AttentionRefinementModule(512, 128)
self.conv_head32 = ConvBNReLU(128, 128, ks=3, stride=1, padding=1)
self.conv_head16 = ConvBNReLU(128, 128, ks=3, stride=1, padding=1)
self.conv_avg = ConvBNReLU(512, 128, ks=1, stride=1, padding=0)
def forward(self, x):
feat8, feat16, feat32 = self.resnet(x)
avg = F.avg_pool2d(feat32, feat32.size()[2:])
avg = self.conv_avg(avg)
avg_up = F.interpolate(avg, feat32.size()[2:], mode='nearest')
feat32_arm = self.arm32(feat32)
feat32_sum = feat32_arm + avg_up
feat32_up = F.interpolate(feat32_sum, feat16.size()[2:], mode='nearest')
feat32_up = self.conv_head32(feat32_up)
feat16_arm = self.arm16(feat16)
feat16_sum = feat16_arm + feat32_up
feat16_up = F.interpolate(feat16_sum, feat8.size()[2:], mode='nearest')
feat16_up = self.conv_head16(feat16_up)
return feat8, feat16_up, feat32_up
class BiSeNet(nn.Module):
"""
BiSeNet 顔パーシングモデル (19クラス) — 公式 zllrunning 実装完全準拠
ラベル: 0=背景, 1=肌, 2=左眉, 3=右眉, 4=左目, 5=右目, 6=眼鏡,
7=左耳, 8=右耳, 9=イヤリング, 10=鼻, 11=口,
12=上唇, 13=下唇, 14=首, 15=ネックレス, 16=服, 17=髪, 18=帽子
"""
FACE_LABELS = [1, 2, 3, 4, 5, 6, 7, 8, 10, 11, 12, 13]
FACE_NECK_LABELS = [1, 2, 3, 4, 5, 6, 7, 8, 10, 11, 12, 13, 14]
MEAN = np.array([0.485, 0.456, 0.406], dtype=np.float32)
STD = np.array([0.229, 0.224, 0.225], dtype=np.float32)
def __init__(self, n_classes=19):
super().__init__()
self.cp = ContextPath()
# ※ SpatialPath は公式では削除済み。feat_res8 (layer2出力) で代用
self.ffm = FeatureFusionModule(256, 256)
self.conv_out = BiSeNetOutput(256, 256, n_classes)
self.conv_out16 = BiSeNetOutput(128, 64, n_classes)
self.conv_out32 = BiSeNetOutput(128, 64, n_classes)
def forward(self, x):
H, W = x.size()[2:]
feat_res8, feat_cp8, feat_cp16 = self.cp(x)
feat_sp = feat_res8 # SpatialPath代替
feat_fuse = self.ffm(feat_sp, feat_cp8)
feat_out = self.conv_out(feat_fuse)
feat_out16 = self.conv_out16(feat_cp8)
feat_out32 = self.conv_out32(feat_cp16)
feat_out = F.interpolate(feat_out, (H, W), mode='bilinear', align_corners=True)
feat_out16 = F.interpolate(feat_out16, (H, W), mode='bilinear', align_corners=True)
feat_out32 = F.interpolate(feat_out32, (H, W), mode='bilinear', align_corners=True)
return feat_out, feat_out16, feat_out32
@torch.no_grad()
def parse(self, img_rgb):
"""RGB画像(numpy HxWx3)を受け取り、19クラスのセグメンテーションマップを返す"""
self.eval()
h0, w0 = img_rgb.shape[:2]
resized = cv2.resize(img_rgb, (512, 512))
inp = resized.astype(np.float32) / 255.0
inp = (inp - self.MEAN) / self.STD
inp = torch.from_numpy(inp.transpose(2, 0, 1)).unsqueeze(0).float()
device = next(self.parameters()).device
inp = inp.to(device)
out, _, _ = self(inp)
seg = out.argmax(1).squeeze().cpu().numpy().astype(np.uint8)
return cv2.resize(seg, (w0, h0), interpolation=cv2.INTER_NEAREST)
@staticmethod
def seg_to_mask(seg, include_neck=False):
labels = BiSeNet.FACE_NECK_LABELS if include_neck else BiSeNet.FACE_LABELS
return np.isin(seg, labels).astype(np.uint8) * 255
# ── メインアプリ ─────────────────────────────────────────────────────────────
class FaceBeautyApp:
def __init__(self, root):
self.root = root
self.root.title("顔検出・美肌効果アプリ (BiSeNet高精度輪郭対応版)")
self.root.geometry("1200x800")
# MediaPipe初期化
self.mp_face_detection = mp.solutions.face_detection
self.mp_face_mesh = mp.solutions.face_mesh
self.mp_selfie_segmentation = mp.solutions.selfie_segmentation
self.face_detection = self.mp_face_detection.FaceDetection(
model_selection=1, min_detection_confidence=0.5)
self.face_mesh = self.mp_face_mesh.FaceMesh(
static_image_mode=True, max_num_faces=10, min_detection_confidence=0.3)
self.selfie_segmentation = self.mp_selfie_segmentation.SelfieSegmentation(
model_selection=1)
# 変数初期化
self.original_image = None
self.current_image = None
self.display_image = None
self.photo = None
self.image_path = None
self.face_boxes = []
self.show_boxes = True
self.face_contours = []
self.beauty_applied = False
self.drag_start = None
self.temp_box = None
self.display_scale = 1.0
self.image_offset = (0, 0)
self.beauty_intensity_applied = 0
self.beauty_mode = 'normal'
self.icc_profile = None # ICCカラープロファイル保持用
# BiSeNet モデル(バックグラウンドで初期化)
self.bisenet_model = None # ロード済みモデル
self.bisenet_ready = False # ロード完了フラグ
self.bisenet_error = None # エラーメッセージ
self._start_bisenet_load() # 非同期ロード開始
# シミ消し用変数
self.spot_removed_image = None # シミ消し後の画像
# 処理状態フラグ
self.detect_done = False
self.contour_done = False
self.spot_removal_done = False
self.beauty_normal_done = False
self.beauty_plus_done = False
# 輪郭編集モード
self.contour_edit_mode = False
self.editing_contour_idx = None
self.edit_points = []
self.edit_mode_type = None
# 輪郭編集履歴(「1つ戻す」用)
self.contour_history = [] # [(face_contours_snapshot, edit_mode_type), ...]
# 輪郭表示フラグ
self.show_contours = True
# tkinterdnd2の有効性チェック
self.dnd_available = False
self.setup_ui()
# ── 輪郭データ構造ヘルパー ────────────────────────────────────────────────
# face_contours の各要素は以下のいずれかを受け付ける(後方互換):
# 旧形式: [(x,y), ...] → 外側輪郭のみ
# 新形式: {"outer": [(x,y),...], "holes": [[(x,y),...], ...]}
#
# 内部では新形式に統一して扱い、描画・マスク生成ともに穴を考慮する。
@staticmethod
def _to_contour_dict(item):
"""旧形式リストを新形式dictに変換(既にdictならそのまま返す)"""
if isinstance(item, dict):
return item
return {"outer": item, "holes": []}
@staticmethod
def _outer_pts(item):
"""外側輪郭の点リストを返す"""
if isinstance(item, dict):
return item["outer"]
return item
@staticmethod
def _hole_pts_list(item):
"""穴輪郭リスト(リストのリスト)を返す"""
if isinstance(item, dict):
return item.get("holes", [])
return []
def _build_mask_from_contours(self, h, w):
"""face_contours から穴考慮済みのマスク(numpy uint8)を生成する"""
mask = np.zeros((h, w), dtype=np.uint8)
for item in self.face_contours:
cd = self._to_contour_dict(item)
outer = np.array(cd["outer"], dtype=np.int32)
cv2.fillPoly(mask, [outer], 255)
for hole in cd.get("holes", []):
hp = np.array(hole, dtype=np.int32)
cv2.fillPoly(mask, [hp], 0) # 穴を黒で塗り戻す
return mask
def setup_ui(self):
# メインフレーム
main_frame = tk.Frame(self.root)
main_frame.pack(fill=tk.BOTH, expand=True)
# 左側コントロールパネル
control_panel = tk.Frame(main_frame, width=250, bg='#f0f0f0')
control_panel.pack(side=tk.LEFT, fill=tk.Y, padx=5, pady=5)
control_panel.pack_propagate(False)
# ファイル選択ボタン
file_frame = tk.LabelFrame(control_panel, text="画像読み込み", bg='#f0f0f0', font=('Arial', 10, 'bold'))
file_frame.pack(fill=tk.X, padx=10, pady=5)
self.load_btn = tk.Button(file_frame, text="ファイル選択", command=self.select_file,
bg='#00BCD4', fg='white', font=('Arial', 10))
self.load_btn.pack(fill=tk.X, padx=5, pady=3)
# 顔検出セクション
face_frame = tk.LabelFrame(control_panel, text="顔検出", bg='#f0f0f0', font=('Arial', 10, 'bold'))
face_frame.pack(fill=tk.X, padx=10, pady=5)
detect_btn_frame = tk.Frame(face_frame, bg='#f0f0f0')
detect_btn_frame.pack(fill=tk.X, padx=5, pady=3)
self.detect_btn = tk.Button(detect_btn_frame, text="顔検出", command=self.detect_faces,
bg='#4CAF50', fg='white', font=('Arial', 10))
self.detect_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.detect_check = tk.Label(detect_btn_frame, text="", bg='#f0f0f0', font=('Arial', 12), width=2)
self.detect_check.pack(side=tk.LEFT)
self.reset_detect_btn = tk.Button(face_frame, text="リセット", command=self.reset_detection,
bg='#ff9800', fg='white', font=('Arial', 9))
self.reset_detect_btn.pack(fill=tk.X, padx=5, pady=3)
# 輪郭抽出セクション
contour_frame = tk.LabelFrame(control_panel, text="輪郭抽出", bg='#f0f0f0', font=('Arial', 10, 'bold'))
contour_frame.pack(fill=tk.X, padx=10, pady=5)
contour_btn_frame = tk.Frame(contour_frame, bg='#f0f0f0')
contour_btn_frame.pack(fill=tk.X, padx=5, pady=3)
self.contour_btn = tk.Button(contour_btn_frame, text="輪郭抽出(BiSeNet)", command=self.extract_contours,
bg='#2196F3', fg='white', font=('Arial', 9))
self.contour_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.contour_check = tk.Label(contour_btn_frame, text="", bg='#f0f0f0', font=('Arial', 12), width=2)
self.contour_check.pack(side=tk.LEFT)
# 輪郭編集ボタン
edit_frame = tk.Frame(contour_frame, bg='#f0f0f0')
edit_frame.pack(fill=tk.X, padx=5, pady=3)
edit_add_btn_frame = tk.Frame(edit_frame, bg='#f0f0f0')
edit_add_btn_frame.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=(0, 2))
self.edit_add_btn = tk.Button(edit_add_btn_frame, text="範囲追加", command=self.toggle_edit_add,
bg='#4CAF50', fg='white', font=('Arial', 9))
self.edit_add_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.edit_add_check = tk.Label(edit_add_btn_frame, text="", bg='#f0f0f0', font=('Arial', 10), width=2)
self.edit_add_check.pack(side=tk.LEFT)
edit_remove_btn_frame = tk.Frame(edit_frame, bg='#f0f0f0')
edit_remove_btn_frame.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=(2, 0))
self.edit_remove_btn = tk.Button(edit_remove_btn_frame, text="範囲削除", command=self.toggle_edit_remove,
bg='#f44336', fg='white', font=('Arial', 9))
self.edit_remove_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.edit_remove_check = tk.Label(edit_remove_btn_frame, text="", bg='#f0f0f0', font=('Arial', 10), width=2)
self.edit_remove_check.pack(side=tk.LEFT)
# リセット+1つ戻すボタン行
reset_undo_frame = tk.Frame(contour_frame, bg='#f0f0f0')
reset_undo_frame.pack(fill=tk.X, padx=5, pady=3)
self.reset_contour_btn = tk.Button(reset_undo_frame, text="リセット", command=self.reset_contours,
bg='#ff9800', fg='white', font=('Arial', 9))
self.reset_contour_btn.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=(0, 2))
self.undo_contour_btn = tk.Button(reset_undo_frame, text="1つ戻す", command=self.undo_contour_edit,
bg='#9E9E9E', fg='white', font=('Arial', 9))
self.undo_contour_btn.pack(side=tk.LEFT, fill=tk.X, expand=True, padx=(2, 0))
# 輪郭表示・非表示トグルボタン
self.toggle_contour_btn = tk.Button(contour_frame, text="輪郭を非表示", command=self.toggle_contour_visibility,
bg='#455A64', fg='white', font=('Arial', 9))
self.toggle_contour_btn.pack(fill=tk.X, padx=5, pady=3)
# シミ消しセクション(輪郭抽出と美肌効果の間)
spot_frame = tk.LabelFrame(control_panel, text="シミ消し", bg='#f0f0f0', font=('Arial', 10, 'bold'))
spot_frame.pack(fill=tk.X, padx=10, pady=5)
spot_btn_frame = tk.Frame(spot_frame, bg='#f0f0f0')
spot_btn_frame.pack(fill=tk.X, padx=5, pady=3)
self.spot_btn = tk.Button(spot_btn_frame, text="シミ消し", command=self.apply_spot_removal,
bg='#795548', fg='white', font=('Arial', 10))
self.spot_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.spot_check = tk.Label(spot_btn_frame, text="", bg='#f0f0f0', font=('Arial', 12), width=2)
self.spot_check.pack(side=tk.LEFT)
# 感度スライダー
spot_slider_frame = tk.Frame(spot_frame, bg='#f0f0f0')
spot_slider_frame.pack(fill=tk.X, padx=5, pady=3)
tk.Label(spot_slider_frame, text="感度:", bg='#f0f0f0', font=('Arial', 9)).pack(side=tk.LEFT)
self.spot_sensitivity_var = tk.IntVar(value=50)
self.spot_slider = tk.Scale(spot_slider_frame, from_=0, to=100, orient=tk.HORIZONTAL,
variable=self.spot_sensitivity_var, bg='#f0f0f0')
self.spot_slider.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.reset_spot_btn = tk.Button(spot_frame, text="リセット", command=self.reset_spot_removal,
bg='#ff9800', fg='white', font=('Arial', 9))
self.reset_spot_btn.pack(fill=tk.X, padx=5, pady=3)
# 美肌効果セクション
beauty_frame = tk.LabelFrame(control_panel, text="美肌効果", bg='#f0f0f0', font=('Arial', 10, 'bold'))
beauty_frame.pack(fill=tk.X, padx=10, pady=5)
beauty_btn_frame = tk.Frame(beauty_frame, bg='#f0f0f0')
beauty_btn_frame.pack(fill=tk.X, padx=5, pady=3)
self.beauty_btn = tk.Button(beauty_btn_frame, text="美肌効果", command=self.apply_beauty,
bg='#E91E63', fg='white', font=('Arial', 10))
self.beauty_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.beauty_normal_check = tk.Label(beauty_btn_frame, text="", bg='#f0f0f0', font=('Arial', 12), width=2)
self.beauty_normal_check.pack(side=tk.LEFT)
beauty_plus_btn_frame = tk.Frame(beauty_frame, bg='#f0f0f0')
beauty_plus_btn_frame.pack(fill=tk.X, padx=5, pady=3)
self.beauty_plus_btn = tk.Button(beauty_plus_btn_frame, text="美肌効果(範囲+)", command=self.apply_beauty_plus,
bg='#F06292', fg='white', font=('Arial', 10))
self.beauty_plus_btn.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.beauty_plus_check = tk.Label(beauty_plus_btn_frame, text="", bg='#f0f0f0', font=('Arial', 12), width=2)
self.beauty_plus_check.pack(side=tk.LEFT)
# 美肌スライダー
slider_frame = tk.Frame(beauty_frame, bg='#f0f0f0')
slider_frame.pack(fill=tk.X, padx=5, pady=3)
tk.Label(slider_frame, text="効果:", bg='#f0f0f0', font=('Arial', 9)).pack(side=tk.LEFT)
self.beauty_var = tk.IntVar(value=38) # 70
self.beauty_slider = tk.Scale(slider_frame, from_=0, to=100, orient=tk.HORIZONTAL,
variable=self.beauty_var, bg='#f0f0f0',
command=self.on_slider_change)
self.beauty_slider.pack(side=tk.LEFT, fill=tk.X, expand=True)
self.reset_beauty_btn = tk.Button(beauty_frame, text="リセット", command=self.reset_beauty,
bg='#ff9800', fg='white', font=('Arial', 9))
self.reset_beauty_btn.pack(fill=tk.X, padx=5, pady=3)
# 保存ボタン
self.save_btn = tk.Button(control_panel, text="保存", command=self.save_image,
bg='#9C27B0', fg='white', font=('Arial', 11, 'bold'))
self.save_btn.pack(fill=tk.X, padx=10, pady=10)
# 使い方ボタン
self.help_btn = tk.Button(control_panel, text="使い方", command=self.show_help,
bg='#607D8B', fg='white', font=('Arial', 10))
self.help_btn.pack(fill=tk.X, padx=10, pady=5)
# 右側画像表示エリア
image_frame = tk.Frame(main_frame, bg='white')
image_frame.pack(side=tk.RIGHT, fill=tk.BOTH, expand=True, padx=5, pady=5)
# キャンバス
self.canvas = tk.Canvas(image_frame, bg='#e0e0e0', cursor='cross')
self.canvas.pack(fill=tk.BOTH, expand=True)
# ウィンドウサイズ変更イベント
self.canvas.bind('<Configure>', self.on_canvas_resize)
# ドラッグ&ドロップ設定
try:
self.canvas.drop_target_register('DND_Files')
self.canvas.dnd_bind('<<Drop>>', self.on_drop)
self.dnd_available = True
except:
pass
# マウスイベント
self.canvas.bind('<Button-1>', self.on_canvas_click)
self.canvas.bind('<B1-Motion>', self.on_canvas_drag)
self.canvas.bind('<ButtonRelease-1>', self.on_canvas_release)
# 初期メッセージ
msg = "ここに画像をドラッグ&ドロップ\nまたは「ファイル選択」ボタンをクリック" if self.dnd_available else "「ファイル選択」ボタンをクリック"
self.canvas.create_text(400, 300, text=msg,
font=('Arial', 14), fill='gray', tags='placeholder')
def on_canvas_resize(self, event):
if self.current_image is not None:
self.display_current_image()
def on_slider_change(self, value):
if self.beauty_applied and self.face_contours:
self.apply_beauty_effect()
def select_file(self):
file_path = filedialog.askopenfilename(
title="画像ファイルを選択",
filetypes=[
("画像ファイル", "*.jpg *.jpeg *.png *.bmp *.gif *.tif *.tiff"),
("すべてのファイル", "*.*")
]
)
if file_path:
self.load_image(file_path)
def on_drop(self, event):
files = self.root.tk.splitlist(event.data)
if files:
self.load_image(files[0])
def load_image(self, path):
try:
path = path.strip('{}').strip('"').strip("'")
# --- ICCカラープロファイル保持のためPILで読み込む ---
# PIL は日本語パスに対応しているが、念のためバイナリ読み込み経由
with open(path, 'rb') as f:
raw_bytes = f.read()
pil_img = Image.open(io.BytesIO(raw_bytes))
# ICCプロファイルを保存(存在しない場合はNone)
self.icc_profile = pil_img.info.get('icc_profile', None)
# RGBに統一(CMYK / グレースケール等にも対応)
if pil_img.mode != 'RGB':
pil_img = pil_img.convert('RGB')
self.original_image = np.array(pil_img)
if self.original_image is None or self.original_image.size == 0:
raise ValueError("画像を読み込めませんでした")
self.image_path = path
self.current_image = self.original_image.copy()
# リセット
self.face_boxes = []
self.face_contours = []
self.beauty_applied = False
self.show_boxes = True
self.beauty_intensity_applied = 0
self.contour_edit_mode = False
self.edit_mode_type = None
self.edit_points = []
self.spot_removed_image = None
self.contour_history = []
self.show_contours = True
# 状態フラグリセット
self.detect_done = False
self.contour_done = False
self.spot_removal_done = False
self.beauty_normal_done = False
self.beauty_plus_done = False
self.update_check_marks()
self.display_current_image()
except Exception as e:
messagebox.showerror("エラー", f"画像の読み込みに失敗しました:\n{str(e)}")
def display_current_image(self):
if self.current_image is None:
return
self.canvas.update_idletasks()
canvas_width = self.canvas.winfo_width()
canvas_height = self.canvas.winfo_height()
if canvas_width <= 1 or canvas_height <= 1:
canvas_width = 800
canvas_height = 600
img = Image.fromarray(self.current_image)
img_width, img_height = img.size
scale = min(canvas_width / img_width, canvas_height / img_height)
new_width = int(img_width * scale)
new_height = int(img_height * scale)
self.display_scale = scale
self.display_image = img.resize((new_width, new_height), Image.LANCZOS)
display_with_overlay = self.display_image.copy()
draw = ImageDraw.Draw(display_with_overlay)
if self.show_boxes and self.face_boxes:
for box in self.face_boxes:
x1, y1, x2, y2 = [int(coord * scale) for coord in box]
draw.rectangle([x1, y1, x2, y2], outline='green', width=3)
if self.face_contours and self.show_contours:
for item in self.face_contours:
outer = self._outer_pts(item)
scaled_outer = [(int(x * scale), int(y * scale)) for x, y in outer]
if len(scaled_outer) > 1:
draw.line(scaled_outer + [scaled_outer[0]], fill='blue', width=2)
# 穴輪郭(シアン)
for hole in self._hole_pts_list(item):
scaled_hole = [(int(x * scale), int(y * scale)) for x, y in hole]
if len(scaled_hole) > 1:
draw.line(scaled_hole + [scaled_hole[0]], fill='cyan', width=2)
if self.contour_edit_mode and self.edit_points:
scaled_edit = [(int(x * scale), int(y * scale)) for x, y in self.edit_points]
if len(scaled_edit) > 1:
color = 'green' if self.edit_mode_type == 'add' else 'red'
draw.line(scaled_edit, fill=color, width=3)
if self.temp_box:
x1, y1, x2, y2 = [int(coord * scale) for coord in self.temp_box]
draw.rectangle([x1, y1, x2, y2], outline='yellow', width=2)
self.photo = ImageTk.PhotoImage(display_with_overlay)
self.canvas.delete('all')
x = (canvas_width - new_width) // 2
y = (canvas_height - new_height) // 2
self.canvas.create_image(x, y, anchor=tk.NW, image=self.photo)
self.image_offset = (x, y)
def update_check_marks(self):
self.detect_check.config(text="✓" if self.detect_done else "")
self.contour_check.config(text="✓" if self.contour_done else "")
self.spot_check.config(text="✓" if self.spot_removal_done else "")
self.beauty_normal_check.config(text="✓" if self.beauty_normal_done else "")
self.beauty_plus_check.config(text="✓" if self.beauty_plus_done else "")
# 編集モードのチェックマーク
self.edit_add_check.config(text="✓" if self.edit_mode_type == 'add' else "")
self.edit_remove_check.config(text="✓" if self.edit_mode_type == 'remove' else "")
# ── BiSeNet モデル管理 ──────────────────────────────────────────────────
def _start_bisenet_load(self):
"""バックグラウンドスレッドで BiSeNet モデルをロード"""
if not TORCH_AVAILABLE:
self.bisenet_error = "PyTorchが見つかりません。\npip install torch torchvision"
return
t = threading.Thread(target=self._load_bisenet_worker, daemon=True)
t.start()
def _load_bisenet_worker(self):
"""ワーカースレッド: モデルファイルを確認・ロード"""
try:
if not os.path.exists(BISENET_MODEL_PATH):
# モデル未ダウンロード → アーキテクチャのみ構築(推論不可)
self.bisenet_error = "MODEL_NOT_FOUND"
return
net = BiSeNet(n_classes=19)
state = torch.load(BISENET_MODEL_PATH,
map_location='cpu', weights_only=False)
# state_dictのキーにprefixがある場合に対応
if isinstance(state, dict):
# 'state_dict'キーがある場合(一部チェックポイント形式)
if 'state_dict' in state:
state = state['state_dict']
# 先頭の'module.'を除去(DataParallel対応)
new_state = {}
for k, v in state.items():
new_key = k[7:] if k.startswith('module.') else k
new_state[new_key] = v
state = new_state
# strict=True で確実にロード(キー不一致があればエラーで検出)
missing, unexpected = net.load_state_dict(state, strict=False)
# 主要レイヤーのキーが missing なら構造不一致として警告
if any('cp.resnet' in k or 'conv_out' in k or 'ffm' in k for k in missing):
raise RuntimeError(
f"モデル構造不一致の可能性があります。\n"
f"Missing keys (先頭10件): {missing[:10]}\n"
f"Unexpected keys (先頭10件): {unexpected[:10]}")
net.eval()
self.bisenet_model = net
self.bisenet_ready = True
except Exception as e:
self.bisenet_error = str(e)
def _ensure_bisenet(self):
"""
extract_contours 呼び出し前に BiSeNet が使える状態か確認。
未ダウンロードならダウンロードダイアログを表示。
戻り値: True=使用可, False=使用不可
"""
if not TORCH_AVAILABLE:
messagebox.showerror(
"PyTorch 未インストール",
"BiSeNet には PyTorch が必要です。\n\n"
"コマンドプロンプト(またはターミナル)で:\n"
" pip install torch torchvision\n\n"
"インストール後、アプリを再起動してください。")
return False
if self.bisenet_ready:
return True
# モデルファイル未ダウンロードの場合
if self.bisenet_error == "MODEL_NOT_FOUND":
ans = messagebox.askyesno(
"BiSeNet モデルのダウンロード",
"顔パーシングモデル (約 50 MB) がまだダウンロードされていません。\n\n"
"【自動ダウンロード】\n"
"「はい」を押すと gdown を使って自動ダウンロードします。\n"
" ※ pip install gdown が必要です。\n\n"
"【手動ダウンロード】\n"
"「いいえ」を押した場合、以下の URL からダウンロードして\n"
f" {BISENET_MODEL_PATH}\n"
"に「79999_iter.pth」という名前で配置してください:\n"
" https://drive.google.com/file/d/154JgKpzCPW82qINcVieuPH3fZ2e0P812/view\n\n"
"自動ダウンロードを試みますか?")
if ans:
self._download_bisenet_dialog()
return False
if self.bisenet_error:
messagebox.showerror("BiSeNet エラー",
f"モデルロードに失敗しました:\n{self.bisenet_error}")
return False
# まだロード中
messagebox.showinfo("準備中", "BiSeNet モデルをロード中です。\nしばらくしてから再度お試しください。")
return False
def _download_bisenet_dialog(self):
"""プログレスダイアログ付きでモデルをダウンロード"""
dlg = tk.Toplevel(self.root)
dlg.title("BiSeNet モデル ダウンロード中")
dlg.geometry("420x160")
dlg.resizable(False, False)
dlg.grab_set()
tk.Label(dlg, text="BiSeNet 顔パーシングモデルをダウンロード中...",
font=('Arial', 10)).pack(pady=(20, 8))
bar = ttk.Progressbar(dlg, mode='indeterminate', length=360)
bar.pack(pady=4)
bar.start(12)
status_var = tk.StringVar(value="接続中...")
tk.Label(dlg, textvariable=status_var, font=('Arial', 9),
fg='#555').pack(pady=4)
def do_download():
try:
import gdown
os.makedirs(os.path.dirname(BISENET_MODEL_PATH), exist_ok=True)
status_var.set("Google Drive からダウンロード中...")
gdown.download(id=BISENET_GDRIVE_ID,
output=BISENET_MODEL_PATH, quiet=True)
if (os.path.exists(BISENET_MODEL_PATH) and
os.path.getsize(BISENET_MODEL_PATH) > 1_000_000):
status_var.set("ロード中...")
self.bisenet_error = None
self._load_bisenet_worker()
dlg.destroy()
if self.bisenet_ready:
messagebox.showinfo("完了",
"BiSeNet モデルのダウンロードとロードが完了しました。\n"
"輪郭抽出を再度実行してください。")
else:
messagebox.showerror("失敗",
f"ロードに失敗しました:\n{self.bisenet_error}")
else:
dlg.destroy()
messagebox.showerror("ダウンロード失敗",
"ファイルのダウンロードに失敗しました。\n"
"手動でダウンロードして配置してください。")
except ImportError:
dlg.destroy()
messagebox.showerror("gdown 未インストール",
"自動ダウンロードには gdown が必要です。\n\n"
"コマンドプロンプトで:\n pip install gdown\n\n"
"または手動ダウンロード:\n"
" https://drive.google.com/file/d/154JgKpzCPW82qINcVieuPH3fZ2e0P812/view\n"
f" → {BISENET_MODEL_PATH} に配置")
except Exception as e:
dlg.destroy()
messagebox.showerror("エラー", f"ダウンロードエラー:\n{e}")
threading.Thread(target=do_download, daemon=True).start()
# ── 輪郭抽出(BiSeNet版) ────────────────────────────────────────────────
def detect_faces(self):
if self.original_image is None:
messagebox.showwarning("警告", "画像を読み込んでください")
return
# 輪郭抽出関連を全てリセット
self.face_contours = []
self.beauty_applied = False
self.current_image = self.original_image.copy()
self.contour_done = False
self.beauty_normal_done = False
self.beauty_plus_done = False
# 編集モードもリセット
self.contour_edit_mode = False
self.edit_mode_type = None
self.edit_points = []
self.contour_history = []
try:
results = self.face_detection.process(self.original_image)
self.face_boxes = []
if results.detections:
h, w, _ = self.original_image.shape
for detection in results.detections:
bbox = detection.location_data.relative_bounding_box
x1 = int(bbox.xmin * w)
y1 = int(bbox.ymin * h)
x2 = int((bbox.xmin + bbox.width) * w)
y2 = int((bbox.ymin + bbox.height) * h)
x1, y1 = max(0, x1), max(0, y1)
x2, y2 = min(w, x2), min(h, y2)
self.face_boxes.append((x1, y1, x2, y2))
if not self.face_boxes:
messagebox.showwarning("検出失敗", "顔を検出できませんでした")
self.detect_done = False
else:
self.detect_done = True
self.show_boxes = True
self.update_check_marks()
self.display_current_image()
except Exception as e:
messagebox.showerror("エラー", f"顔検出に失敗しました:\n{str(e)}")
def reset_detection(self):
self.face_boxes = []
self.face_contours = []
self.beauty_applied = False
self.show_boxes = True
self.current_image = self.original_image.copy() if self.original_image is not None else None
self.detect_done = False
self.contour_done = False
self.spot_removed_image = None
self.spot_removal_done = False
self.beauty_normal_done = False
self.beauty_plus_done = False
self.contour_edit_mode = False
self.edit_mode_type = None
self.contour_history = []
self.show_contours = True
self.toggle_contour_btn.config(text="輪郭を非表示", bg='#455A64')
self.update_check_marks()
self.display_current_image()
def extract_contours(self):
"""BiSeNet(ROIクロップ個別推論)による高精度輪郭抽出"""
if not self.face_boxes:
messagebox.showwarning("警告", "先に顔検出を実行してください")
return
if not self._ensure_bisenet():
return
self.beauty_applied = False
self.current_image = self.original_image.copy()
self.beauty_normal_done = False
self.beauty_plus_done = False
self.spot_removed_image = None
self.spot_removal_done = False
try:
h, w = self.original_image.shape[:2]
net = self.bisenet_model
face_labels = [1, 2, 3, 4, 5, 6, 7, 8, 10, 11, 12, 13]
self.face_contours = []
failed_boxes = [] # BiSeNet失敗したboxをフォールバック用に保持
for box in self.face_boxes:
x1, y1, x2, y2 = [int(v) for v in box]
bw, bh = x2 - x1, y2 - y1
# ── ROI を顔ボックスより大きめに切り出す ──────────────────
# 顔が小さくても512x512に拡大して推論→精度向上
margin_x = int(bw * 0.50)
margin_y_top = int(bh * 0.35)
margin_y_bot = int(bh * 0.80) # 首まで余裕を持たせる
rx1 = max(0, x1 - margin_x)
ry1 = max(0, y1 - margin_y_top)
rx2 = min(w, x2 + margin_x)
ry2 = min(h, y2 + margin_y_bot)
roi_w = rx2 - rx1
roi_h = ry2 - ry1
if roi_w < 4 or roi_h < 4:
failed_boxes.append(box)
continue
# ── ROIだけ切り出して BiSeNet で512x512推論 ───────────────
roi_img = self.original_image[ry1:ry2, rx1:rx2]
seg_roi_512 = net.parse(roi_img) # ROIを512x512→推論→元ROIサイズに戻す
# ── 顔ラベルマスク生成 ────────────────────────────────────
face_mask_roi = np.isin(seg_roi_512, face_labels).astype(np.uint8) * 255
# BiSeNet認識率チェック(ROI面積の5%未満なら失敗と判断)
bisenet_ok = cv2.countNonZero(face_mask_roi) >= roi_w * roi_h * 0.05
if not bisenet_ok:
failed_boxes.append(box)
continue
# ── 首ラベル(14)を顎ライン以下・顔幅内のみ追加 ─────────
neck_roi = (seg_roi_512 == 14).astype(np.uint8) * 255
face_ys = np.where(face_mask_roi > 0)[0]
if face_ys.size > 0:
jaw_y = int(np.percentile(face_ys, 88))
neck_below = np.zeros_like(neck_roi)
neck_below[jaw_y:, :] = neck_roi[jaw_y:, :]
face_xs = np.where(face_mask_roi > 0)[1]
if face_xs.size > 0:
fx_m = int((face_xs.max() - face_xs.min()) * 0.12)
nfx1 = max(0, face_xs.min() - fx_m)
nfx2 = min(face_mask_roi.shape[1], face_xs.max() + fx_m)
neck_r = np.zeros_like(neck_roi)
neck_r[:, nfx1:nfx2] = neck_below[:, nfx1:nfx2]
face_mask_roi = cv2.bitwise_or(face_mask_roi, neck_r)
# ── マスク整形:穴埋め→ノイズ除去→平滑化 ─────────────────
k_close = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (13, 13))
k_open = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (5, 5))
m = cv2.morphologyEx(face_mask_roi, cv2.MORPH_CLOSE, k_close, iterations=2)
m = cv2.morphologyEx(m, cv2.MORPH_OPEN, k_open, iterations=1)
m = (cv2.GaussianBlur(m.astype(np.float32), (9, 9), 0) > 80).astype(np.uint8) * 255
# 最大連結成分のみ残す
n_lab, labels_map, stats, _ = cv2.connectedComponentsWithStats(m)
if n_lab <= 1:
failed_boxes.append(box)
continue
largest_id = 1 + np.argmax(stats[1:, cv2.CC_STAT_AREA])
m = (labels_map == largest_id).astype(np.uint8) * 255
if cv2.countNonZero(m) < bw * bh * 0.05:
failed_boxes.append(box)
continue
# ── 輪郭取得&座標をROI→元画像に変換 ────────────────────
contours_found, _ = cv2.findContours(
m, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_NONE)
if not contours_found:
failed_boxes.append(box)
continue
largest = max(contours_found, key=cv2.contourArea)
# 点数を絞りながら滑らかに近似
epsilon = 0.002 * cv2.arcLength(largest, True)
approx = cv2.approxPolyDP(largest, epsilon, True)
# ROI座標 → 元画像座標へオフセット
pts = [(int(p[0][0]) + rx1, int(p[0][1]) + ry1) for p in approx]
if len(pts) > 300:
step = max(1, len(pts) // 300)
pts = pts[::step]
if len(pts) > 10:
self.face_contours.append(pts)
# ── BiSeNet失敗分をMediaPipeメッシュでフォールバック ────────────
if failed_boxes:
self._fallback_mediapipe(failed_boxes)
# ── 結果反映 ──────────────────────────────────────────────────
if not self.face_contours:
messagebox.showwarning(
"抽出失敗",
"顔領域の輪郭を抽出できませんでした。\n"
"顔検出をやり直してから再度お試しください。")
self.contour_done = False
self.show_boxes = True
else:
success = len(self.face_contours)
total = len(self.face_boxes)
self.contour_done = True
self.show_boxes = False
if failed_boxes:
messagebox.showinfo(
"輪郭抽出完了",
f"{total}人中 {success}人の輪郭を抽出しました。\n"
f"({len(failed_boxes)}人はMediaPipeで補完)")
self.update_check_marks()
self.display_current_image()
except Exception as e:
import traceback
messagebox.showerror("エラー",
f"輪郭抽出に失敗しました:\n{str(e)}\n\n"
f"{traceback.format_exc()[-500:]}")
def _fallback_mediapipe(self, boxes):
"""BiSeNet失敗時にMediaPipe FaceMeshで輪郭を生成するフォールバック"""
# 顔輪郭に対応するFaceMeshのランドマークインデックス(楕円より精度が高い)
OVAL_IDX = [
10, 338, 297, 332, 284, 251, 389, 356, 454, 323, 361, 288,
397, 365, 379, 378, 400, 377, 152, 148, 176, 149, 150, 136,
172, 58, 132, 93, 234, 127, 162, 21, 54, 103, 67, 109
]
h, w = self.original_image.shape[:2]
results = self.face_mesh.process(self.original_image)
for box in boxes:
x1, y1, x2, y2 = [int(v) for v in box]
cx_box = (x1 + x2) / 2
cy_box = (y1 + y2) / 2
matched = False
# MediaPipeが検出した顔の中でboxに最も近いものを選択
if results.multi_face_landmarks:
best_lm = None
best_dist = float('inf')
for face_lm in results.multi_face_landmarks:
xs = [lm.x * w for lm in face_lm.landmark]
ys = [lm.y * h for lm in face_lm.landmark]
cx_lm = float(np.mean(xs))
cy_lm = float(np.mean(ys))
dist = ((cx_box - cx_lm) ** 2 + (cy_box - cy_lm) ** 2) ** 0.5
if dist < best_dist:
best_dist = dist
best_lm = face_lm
if best_lm and best_dist < max(x2 - x1, y2 - y1):
pts = []
for idx in OVAL_IDX:
lm = best_lm.landmark[idx]
pts.append((int(lm.x * w), int(lm.y * h)))
if len(pts) > 10:
self.face_contours.append(pts)
matched = True
# MediaPipeでも取れなかった場合は楕円(最終手段)
if not matched:
cx = (x1 + x2) // 2
cy = (y1 + y2) // 2
ax = (x2 - x1) // 2
ay = int((y2 - y1) // 2 * 1.1)
pts = []
for angle in range(0, 360, 4):
rad = np.radians(angle)
pts.append((int(cx + ax * np.cos(rad)),
int(cy + ay * np.sin(rad))))
if len(pts) > 10:
self.face_contours.append(pts)
def toggle_edit_add(self):
"""範囲追加モードのトグル"""
if self.original_image is None:
messagebox.showwarning("警告", "画像を読み込んでください")
return
# 輪郭がない場合は空のリストで開始
if not self.face_contours:
self.face_contours = []
# 範囲追加モードの場合は継続、そうでない場合は開始
if self.edit_mode_type == 'add':
# 既に追加モードの場合は何もしない(継続)
pass
else:
# 編集モードを追加に変更
self.contour_edit_mode = True
self.edit_mode_type = 'add'
self.edit_points = []
# 顔検出枠を非表示
self.show_boxes = False
self.update_check_marks()
self.display_current_image()
def toggle_edit_remove(self):
"""範囲削除モードのトグル"""
if self.original_image is None:
messagebox.showwarning("警告", "画像を読み込んでください")
return
# 輪郭がない場合は空のリストで開始
if not self.face_contours:
self.face_contours = []
# 範囲削除モードの場合は継続、そうでない場合は開始
if self.edit_mode_type == 'remove':
# 既に削除モードの場合は何もしない(継続)
pass
else:
# 編集モードを削除に変更
self.contour_edit_mode = True
self.edit_mode_type = 'remove'
self.edit_points = []
# 顔検出枠を非表示
self.show_boxes = False
self.update_check_marks()
self.display_current_image()
def apply_contour_edit(self):
"""マウスで描いた範囲に基づいて輪郭を編集"""
if not self.edit_points or len(self.edit_points) < 3:
return
# 編集前の状態を履歴に保存
import copy
self.contour_history.append((copy.deepcopy(self.face_contours), self.edit_mode_type))
h, w = self.original_image.shape[:2]
edit_mask = np.zeros((h, w), dtype=np.uint8)
edit_polygon = np.array(self.edit_points, dtype=np.int32)
cv2.fillPoly(edit_mask, [edit_polygon], 255)
if not self.face_contours or len(self.face_contours) == 0:
# 輪郭が存在しない場合、新規作成
if self.edit_mode_type == 'add':
contours, _ = cv2.findContours(edit_mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
if contours:
largest = max(contours, key=cv2.contourArea)
epsilon = 0.003 * cv2.arcLength(largest, True)
smoothed = cv2.approxPolyDP(largest, epsilon, True)
new_contour = [(int(point[0][0]), int(point[0][1])) for point in smoothed]
if len(new_contour) > 10:
self.face_contours = [new_contour]
else:
# 既存の輪郭を編集
if self.edit_mode_type == 'add':
# 追加モード:既存の輪郭とマージするか、新規領域として追加
# 既存の穴(holes)情報を収集しておく
all_existing_holes = []
for item in self.face_contours:
cd = self._to_contour_dict(item)
for hole in cd.get("holes", []):
all_existing_holes.append(hole)
# 外周のみのマスクを作成(穴は塗り戻さない)して追加範囲と統合
outer_only_mask = np.zeros((h, w), dtype=np.uint8)
for item in self.face_contours:
cd = self._to_contour_dict(item)
outer_arr = np.array(cd["outer"], dtype=np.int32)
cv2.fillPoly(outer_only_mask, [outer_arr], 255)
combined_mask = cv2.bitwise_or(outer_only_mask, edit_mask)
# ノイズ除去
kernel = np.ones((3, 3), np.uint8)
combined_mask = cv2.morphologyEx(combined_mask, cv2.MORPH_CLOSE, kernel)
combined_mask = cv2.morphologyEx(combined_mask, cv2.MORPH_OPEN, kernel)
# 新しい外周輪郭を抽出(複数の独立した領域を保持)
contours, _ = cv2.findContours(combined_mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
new_contours = []
if contours:
for cnt in contours:
if cv2.contourArea(cnt) > 100:
epsilon = 0.003 * cv2.arcLength(cnt, True)
smoothed = cv2.approxPolyDP(cnt, epsilon, True)
new_outer = [(int(point[0][0]), int(point[0][1])) for point in smoothed]
if len(new_outer) > 10:
# この新外周の内側に収まる穴のみ引き継ぐ
new_outer_mask = np.zeros((h, w), dtype=np.uint8)
cv2.fillPoly(new_outer_mask, [np.array(new_outer, dtype=np.int32)], 255)
# 追加範囲と重なる穴は消去(追加で埋まるため)
add_overlap = cv2.bitwise_and(new_outer_mask, edit_mask)
kept_holes = []
for hole in all_existing_holes:
hole_arr = np.array(hole, dtype=np.int32)
hole_mask = np.zeros((h, w), dtype=np.uint8)
cv2.fillPoly(hole_mask, [hole_arr], 255)
# 穴が新外周の内側にあるか確認
inside = cv2.bitwise_and(hole_mask, new_outer_mask)
if cv2.countNonZero(inside) == 0:
continue
# 穴が追加範囲と重なっていないか確認(追加で埋まった穴は除外)
overlap_with_add = cv2.bitwise_and(hole_mask, add_overlap)
if cv2.countNonZero(overlap_with_add) > 0:
continue
kept_holes.append(hole)
new_contours.append({"outer": new_outer, "holes": kept_holes})
if new_contours:
self.face_contours = new_contours
else:
# ── 削除モード ─────────────────────────────────────────────
# ・削除範囲が外周形状の輪郭内に収まる(中抜き)
# → 穴(holes)として登録 → 水色(シアン)で描画
# ・削除範囲が外周形状そのものに掛かる(外周を削る)
# → 外周を削り直した新外周として登録 → 青のまま描画
# ・削除範囲が外周全体を覆う → 輪郭ごと除去
new_contours = []
for item in self.face_contours:
cd = self._to_contour_dict(item)
outer_array = np.array(cd["outer"], dtype=np.int32)
# 外側輪郭マスクを作成(穴は考慮しない純粋な外形)
outer_only_mask = np.zeros((h, w), dtype=np.uint8)
cv2.fillPoly(outer_only_mask, [outer_array], 255)
# 既存の穴も反映した有効マスク
outer_mask = outer_only_mask.copy()
for existing_hole in cd.get("holes", []):
cv2.fillPoly(outer_mask, [np.array(existing_hole, dtype=np.int32)], 0)
# 削除範囲と有効マスクの交差
intersection = cv2.bitwise_and(edit_mask, outer_mask)
if cv2.countNonZero(intersection) == 0:
# この輪郭と削除範囲が重ならない → そのまま保持
new_contours.append(cd)
continue
# 削除後に残る有効領域
remaining_mask = cv2.bitwise_and(outer_mask, cv2.bitwise_not(edit_mask))
if cv2.countNonZero(remaining_mask) == 0:
# 有効領域が全て削除範囲に含まれる → 輪郭ごと除去(青線も消える)
continue
# ── 削除範囲が外周形状に掛かっているか判定 ───────────────
# 「外周ライン上」に削除範囲が重なっているかを確認する。
# 外周ラインのみのマスク(細線)を作成して削除範囲との重なりを見る。
outer_line_mask = np.zeros((h, w), dtype=np.uint8)
cv2.drawContours(outer_line_mask, [outer_array], -1, 255, thickness=4)
overlap_with_outline = cv2.bitwise_and(edit_mask, outer_line_mask)
touches_outline = cv2.countNonZero(overlap_with_outline) > 0
# さらに削除範囲が外周マスクの外側にもはみ出しているか確認
edit_outside_outer = cv2.bitwise_and(edit_mask, cv2.bitwise_not(outer_only_mask))
extends_outside = cv2.countNonZero(edit_outside_outer) > 0
if touches_outline or extends_outside:
# ── 外周形状を削る削除 → 残った領域を新外周(青)として再登録 ──
# remaining_mask から新しい外周輪郭を求める
kernel = np.ones((3, 3), np.uint8)
remaining_clean = cv2.morphologyEx(remaining_mask, cv2.MORPH_CLOSE, kernel)
new_outer_contours, _ = cv2.findContours(
remaining_clean, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
for ocnt in new_outer_contours:
if cv2.contourArea(ocnt) > 100:
epsilon = 0.003 * cv2.arcLength(ocnt, True)
smoothed_o = cv2.approxPolyDP(ocnt, epsilon, True)
new_outer_pts = [(int(p[0][0]), int(p[0][1])) for p in smoothed_o]
if len(new_outer_pts) > 3:
# 穴は引き継がない(外周を削り直したので穴は残らない)
new_contours.append({"outer": new_outer_pts, "holes": []})
else:
# ── 輪郭内部の中抜き → 穴(水色)として登録 ──────────
hole_contours, _ = cv2.findContours(
intersection, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
new_holes = list(cd.get("holes", []))
for hcnt in hole_contours:
if cv2.contourArea(hcnt) > 50:
epsilon = 0.003 * cv2.arcLength(hcnt, True)
smoothed_h = cv2.approxPolyDP(hcnt, epsilon, True)
hole_pts = [(int(p[0][0]), int(p[0][1])) for p in smoothed_h]
if len(hole_pts) > 3:
new_holes.append(hole_pts)
new_contours.append({"outer": cd["outer"], "holes": new_holes})
if new_contours:
self.face_contours = new_contours
# 美肌効果が適用されている場合は再適用
if self.beauty_applied:
self.apply_beauty_effect()
def reset_contours(self):
self.face_contours = []
self.beauty_applied = False
self.show_boxes = True
self.current_image = self.original_image.copy() if self.original_image is not None else None
self.contour_done = False
self.spot_removed_image = None
self.spot_removal_done = False
self.beauty_normal_done = False
self.beauty_plus_done = False
self.contour_edit_mode = False
self.edit_mode_type = None
self.contour_history = []
self.show_contours = True
self.toggle_contour_btn.config(text="輪郭を非表示", bg='#455A64')
self.update_check_marks()
self.display_current_image()
def undo_contour_edit(self):
"""最後の範囲追加・範囲解除を1つ戻す"""
if not self.contour_history:
return
import copy
prev_contours, _ = self.contour_history.pop()
self.face_contours = copy.deepcopy(prev_contours)
# 美肌効果が適用されている場合は再適用
if self.beauty_applied:
self.apply_beauty_effect()
self.update_check_marks()
self.display_current_image()
def toggle_contour_visibility(self):
"""輪郭の表示・非表示を切り替える(マスク効果には影響なし)"""
self.show_contours = not self.show_contours
if self.show_contours:
self.toggle_contour_btn.config(text="輪郭を非表示", bg='#455A64')
else:
self.toggle_contour_btn.config(text="輪郭を表示", bg='#78909C')
self.display_current_image()
def apply_spot_removal(self):
"""顔領域内のシミを自動検出して除去する"""
if not self.face_contours and not self.face_boxes:
messagebox.showwarning("警告", "先に輪郭抽出または顔検出を実行してください")
return
try:
sensitivity = self.spot_sensitivity_var.get() / 100.0
h, w = self.original_image.shape[:2]
# ── 1. 顔マスク作成 ──────────────────────────────
face_mask = np.zeros((h, w), dtype=np.uint8)
if self.face_contours:
face_mask = self._build_mask_from_contours(h, w)
else:
for box in self.face_boxes:
x1, y1, x2, y2 = [int(v) for v in box]
cx, cy = (x1 + x2) // 2, (y1 + y2) // 2
ax, ay = (x2 - x1) // 2, (y2 - y1) // 2
cv2.ellipse(face_mask, (cx, cy), (ax, ay), 0, 0, 360, 255, -1)
# ── 2. LAB色空間でL(明度)チャンネル取得 ──────────
lab = cv2.cvtColor(self.original_image, cv2.COLOR_RGB2LAB)
l_channel = lab[:, :, 0].astype(np.float32)
# ── 3. 周囲の肌色基準(大きめのブラー)を計算 ────
# 顔マスク内のみ処理するため、マスク外はブラーに影響しないよう補完
# 顔内のみのL値でGaussianBlurを計算(マスク付きBlur)
blur_size = max(51, int(min(h, w) * 0.08) | 1) # 奇数保証
if blur_size % 2 == 0:
blur_size += 1
l_masked = l_channel.copy()
# 顔マスク外を平均値で埋めてブラー計算のエッジ影響を抑制
face_mean_l = float(l_channel[face_mask == 255].mean()) if face_mask.sum() > 0 else 128.0
l_masked[face_mask == 0] = face_mean_l
background_l = cv2.GaussianBlur(l_masked, (blur_size, blur_size), 0)
# ── 4. シミ検出:周囲より暗い領域を検出 ──────────
# diff > 0 : 背景より暗い(シミ候補)
diff = background_l - l_channel
# 感度に応じた閾値(0-100%感度 → 閾値12〜4)
threshold = 12.0 - sensitivity * 8.0
threshold = max(3.0, threshold)
spot_mask = np.zeros((h, w), dtype=np.uint8)
spot_mask[diff > threshold] = 255
# ── 5. 顔マスク内のみに限定 ───────────────────────
spot_mask = cv2.bitwise_and(spot_mask, face_mask)
# ── 6. サイズフィルタ(目・眉・鼻などを除外) ─────
# 感度に応じて最大スポットサイズを調整
min_spot_px = 4
max_spot_px = int(80 + sensitivity * 200) # 感度50%で180px、100%で280px
num_labels, labels, stats, _ = cv2.connectedComponentsWithStats(spot_mask)
filtered_mask = np.zeros((h, w), dtype=np.uint8)
detected_count = 0
for i in range(1, num_labels):
area = stats[i, cv2.CC_STAT_AREA]
if min_spot_px <= area <= max_spot_px:
filtered_mask[labels == i] = 255
detected_count += 1
if detected_count == 0:
messagebox.showinfo(
"シミ未検出",
"シミが検出されませんでした。\n「感度」スライダーを上げて再試行してください。"
)
return
# ── 7. マスクを少し膨張してシミ周囲も自然に補完 ──
dilate_iter = max(1, int(1 + sensitivity * 2))
dilate_kernel = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (3, 3))
dilated_mask = cv2.dilate(filtered_mask, dilate_kernel, iterations=dilate_iter)
# 顔マスク外に膨張しないよう制限
dilated_mask = cv2.bitwise_and(dilated_mask, face_mask)
# ── 8. cv2.inpaint でシミ部分を周囲の肌色で補完 ──
result_bgr = cv2.cvtColor(self.original_image, cv2.COLOR_RGB2BGR)
inpaint_radius = max(5, int(7 + sensitivity * 5))
inpainted_bgr = cv2.inpaint(result_bgr, dilated_mask, inpaint_radius, cv2.INPAINT_TELEA)
inpainted = cv2.cvtColor(inpainted_bgr, cv2.COLOR_BGR2RGB)
# ── 9. エッジを自然にブレンド ───────────────────
blend_mask = cv2.GaussianBlur(dilated_mask.astype(np.float32), (7, 7), 0) / 255.0
blend_3ch = np.stack([blend_mask] * 3, axis=2)
result = (self.original_image.astype(np.float32) * (1.0 - blend_3ch)
+ inpainted.astype(np.float32) * blend_3ch).astype(np.uint8)
# ── 10. 結果を保持 ───────────────────────────────
self.spot_removed_image = result
self.current_image = result.copy()
self.spot_removal_done = True
# 美肌効果が適用されていた場合は再適用
if self.beauty_applied:
self.apply_beauty_effect()
self.update_check_marks()
self.display_current_image()
messagebox.showinfo("完了", f"シミ消し完了:{detected_count}箇所を除去しました。")
except Exception as e:
messagebox.showerror("エラー", f"シミ消しに失敗しました:\n{str(e)}")
def reset_spot_removal(self):
"""シミ消し効果をリセットして元画像に戻す"""
if self.original_image is not None:
self.spot_removed_image = None
self.spot_removal_done = False
# 美肌効果が適用されていた場合は元画像から再適用
if self.beauty_applied:
self.apply_beauty_effect()
else:
self.current_image = self.original_image.copy()
self.update_check_marks()
self.display_current_image()
def apply_beauty(self):
if not self.face_contours and not self.face_boxes:
messagebox.showwarning("警告", "先に顔検出を実行してください")
return
self.beauty_applied = True
self.beauty_mode = 'normal'
self.beauty_normal_done = True
self.beauty_plus_done = False
self.update_check_marks()
self.apply_beauty_effect()
def apply_beauty_plus(self):
if not self.face_contours and not self.face_boxes:
messagebox.showwarning("警告", "先に顔検出を実行してください")
return
self.beauty_applied = True
self.beauty_mode = 'plus'
self.beauty_plus_done = True
self.beauty_normal_done = False
self.update_check_marks()
self.apply_beauty_effect()
def apply_beauty_effect(self):
if not self.face_contours and not self.face_boxes:
return
try:
intensity = self.beauty_var.get() / 100.0
# シミ消し済み画像があればそれをベースに、なければ元画像を使用
base_image = self.spot_removed_image if self.spot_removed_image is not None else self.original_image
result = base_image.copy()
h, w = result.shape[:2]
if self.face_contours:
contours_to_process = self.face_contours
else:
contours_to_process = []
for box in self.face_boxes:
x1, y1, x2, y2 = box
center_x = (x1 + x2) // 2
center_y = (y1 + y2) // 2
width = x2 - x1
height = y2 - y1
ellipse_contour = []
for angle in range(0, 360, 5):
rad = np.radians(angle)
x = int(center_x + (width / 2) * np.cos(rad))
y = int(center_y + (height / 2) * np.sin(rad))
ellipse_contour.append((x, y))
contours_to_process.append(ellipse_contour)
for item in contours_to_process:
# 外側輪郭・穴を取得
outer = self._outer_pts(item)
holes = self._hole_pts_list(item)
pts = np.array(outer, dtype=np.int32)
if self.beauty_mode == 'plus':
min_y = np.min(pts[:, 1])
max_y = np.max(pts[:, 1])
min_x = np.min(pts[:, 0])
max_x = np.max(pts[:, 0])
face_height = max_y - min_y
face_width = max_x - min_x
forehead_extend = int(face_height * 0.4)
neck_extend = int(face_height * 0.3)
side_extend = int(face_width * 0.1)
extended_contour = []
for x, y in outer:
if y < min_y + face_height * 0.3:
new_y = y - forehead_extend * (1 - (y - min_y) / (face_height * 0.3))
elif y > max_y - face_height * 0.2:
ratio = (y - (max_y - face_height * 0.2)) / (face_height * 0.2)
new_y = y + neck_extend * ratio
else:
new_y = y
if x < min_x + face_width * 0.3:
new_x = x - side_extend * (1 - (x - min_x) / (face_width * 0.3))
elif x > max_x - face_width * 0.3:
new_x = x + side_extend * ((x - (max_x - face_width * 0.3)) / (face_width * 0.3))
else:
new_x = x
extended_contour.append((int(new_x), int(new_y)))
pts = np.array(extended_contour, dtype=np.int32)
# マスク生成(外側を塗り、穴を黒で抜く)
mask = np.zeros(result.shape[:2], dtype=np.uint8)
cv2.fillPoly(mask, [pts], 255)
for hole in holes:
cv2.fillPoly(mask, [np.array(hole, dtype=np.int32)], 0)
blur_size = 25 if self.beauty_mode == 'plus' else 15
mask = cv2.GaussianBlur(mask, (blur_size, blur_size), 0)
kernel_size = max(5, int(5 + 10 * intensity))
if kernel_size % 2 == 0:
kernel_size += 1
smoothed = cv2.bilateralFilter(result, kernel_size, 30 + 30 * intensity, 30 + 30 * intensity)
brightness = cv2.convertScaleAbs(smoothed, alpha=1.0, beta=int(5 * intensity))
mask_float = mask.astype(float) / 255.0 * intensity
mask_3ch = np.stack([mask_float] * 3, axis=2)
result = (result * (1 - mask_3ch) + brightness * mask_3ch).astype(np.uint8)
self.current_image = result
self.beauty_intensity_applied = self.beauty_var.get()
self.display_current_image()
except Exception as e:
messagebox.showerror("エラー", f"美肌効果の適用に失敗しました:\n{str(e)}")
def reset_beauty(self):
if self.original_image is not None:
# シミ消しが適用されている場合はシミ消し後の画像に戻す
if self.spot_removed_image is not None:
self.current_image = self.spot_removed_image.copy()
else:
self.current_image = self.original_image.copy()
self.beauty_applied = False
self.beauty_normal_done = False
self.beauty_plus_done = False
self.update_check_marks()
self.display_current_image()
def save_image(self):
if self.current_image is None:
messagebox.showwarning("警告", "保存する画像がありません")
return
# 変数の初期化
init_dir = os.path.expanduser("~")
beauty_value = self.beauty_var.get()
spot_value = self.spot_sensitivity_var.get()
# ── ステップ実施分だけ末尾に追加するファイル名を構築 ──
# 顔検出・輪郭抽出だけでは何も足さない
# シミ消し実施 → +シミ消しxx
# 美肌効果実施 → +美肌効果xx(範囲+の場合は +美肌効果+xx)
step_suffix = ""
if self.spot_removal_done:
step_suffix += f"+シミ消し{spot_value}"
if self.beauty_applied:
if self.beauty_mode == 'plus':
step_suffix += f"+美肌効果+{beauty_value}"
else:
step_suffix += f"+美肌効果{beauty_value}"
if self.image_path:
init_dir = os.path.dirname(self.image_path)
base_name_no_ext = os.path.splitext(os.path.basename(self.image_path))[0]
ext = os.path.splitext(self.image_path)[1].lower()
try:
temp_initial_file = f"{base_name_no_ext}{step_suffix}{ext}"
except:
temp_initial_file = f"{base_name_no_ext}{step_suffix}.png"
ext = '.png'
# 拡張子とファイルタイプの優先順位を決定
if ext in ('.jpg', '.jpeg'):
default_ext = '.jpg'
filetypes_list = [("JPEG画像", "*.jpg"), ("PNG画像", "*.png"), ("すべてのファイル", "*.*")]
elif ext == '.png':
default_ext = '.png'
filetypes_list = [("PNG画像", "*.png"), ("JPEG画像", "*.jpg"), ("すべてのファイル", "*.*")]
else:
default_ext = '.png'
filetypes_list = [("PNG画像", "*.png"), ("JPEG画像", "*.jpg"), ("すべてのファイル", "*.*")]
# initialfile には拡張子を除去して渡す(ダイアログの初期選択問題を解決するため)
initial_filename_no_ext = os.path.splitext(temp_initial_file)[0]
else:
# 画像がロードされていない場合のデフォルト
default_ext = ".jpg"
initial_filename_no_ext = f"編集済み{step_suffix}"
filetypes_list = [("JPEG画像", "*.jpg"), ("PNG画像", "*.png"), ("すべてのファイル", "*.*")]
filepath = filedialog.asksaveasfilename(
initialdir=init_dir,
initialfile=initial_filename_no_ext, # 拡張子なしのファイル名を渡す
defaultextension=default_ext,
filetypes=filetypes_list
)
if filepath:
try:
# numpy配列 → PIL Image(RGB)
img_pil = Image.fromarray(self.current_image)
# ユーザーが選択した拡張子を確認
save_ext = os.path.splitext(filepath)[1].lower()
# ICCプロファイルを保存オプションに含める
save_kwargs = {}
if self.icc_profile:
save_kwargs['icc_profile'] = self.icc_profile
# 拡張子補完(拡張子なし or 不明な場合)
if save_ext not in ('.jpg', '.jpeg', '.png'):
if default_ext == '.jpg':
filepath += '.jpg'
save_ext = '.jpg'
else:
filepath += '.png'
save_ext = '.png'
# --- PIL で保存(日本語パス対応のため BytesIO 経由)---
buf = io.BytesIO()
if save_ext in ('.jpg', '.jpeg'):
img_pil.save(buf, format='JPEG', quality=95,
subsampling=0, **save_kwargs)
else:
img_pil.save(buf, format='PNG', **save_kwargs)
with open(filepath, 'wb') as f:
f.write(buf.getvalue())
except Exception as e:
messagebox.showerror("エラー", f"画像の保存に失敗しました:\n{str(e)}")
def show_help(self):
help_text = """【使い方】
1. 画像の読み込み
「ファイル選択」ボタンから画像を選択
(ドラッグ&ドロップも可能)
2. 顔検出
「顔検出」ボタンで自動的に顔を検出
- 緑の枠で顔を囲みます
- 枠をクリックで除外可能
- マウスドラッグで手動追加可能
3. 輪郭抽出
「輪郭抽出(BiSeNet)」で顔・首領域を高精度抽出
- BiSeNet が19クラス(肌/眉/目/鼻/口/耳/首)を個別認識
- 髪・背景・服を自動除外した正確な輪郭を生成
- 初回起動時にモデル(約50MB)の自動ダウンロードが必要
- ※ pip install gdown が必要(自動DL使用時)
4. 輪郭編集
「範囲追加」「範囲削除」で輪郭を調整
- ボタンを押してマウスドラッグで範囲指定
- 連続して複数回範囲指定可能
- 輪郭抽出なしでも使用可能
- 独立した複数領域の追加も可能
- 美肌効果後も編集可能(自動再適用)
5. シミ消し ★NEW★
「シミ消し」ボタンで顔領域内のシミを自動除去
- 輪郭抽出または顔検出の後に実行
- 感度スライダーで検出の強さを調整(0-100)
低め:目立つシミのみ / 高め:薄いシミまで除去
- 美肌効果と組み合わせると更に効果的
- リセットで元の状態に戻せます
6. 美肌効果
「美肌効果」ボタンで肌を滑らかに
「美肌効果(範囲+)」で額・首も含む
- スライダーで効果を調整(0-100)
- スライダー操作でリアルタイム更新
7. 保存
「保存」ボタンで加工画像を保存
※各機能に「リセット」ボタンあり
※推奨手順:顔検出→輪郭抽出→シミ消し→美肌効果"""
messagebox.showinfo("使い方", help_text)
def on_canvas_click(self, event):
if self.original_image is None:
return
if self.contour_edit_mode:
x = (event.x - self.image_offset[0]) / self.display_scale
y = (event.y - self.image_offset[1]) / self.display_scale
self.edit_points = [(x, y)]
return
if self.face_boxes and self.show_boxes:
x = (event.x - self.image_offset[0]) / self.display_scale
y = (event.y - self.image_offset[1]) / self.display_scale
for i, box in enumerate(self.face_boxes):
x1, y1, x2, y2 = box
if x1 <= x <= x2 and y1 <= y <= y2:
self.face_boxes.pop(i)
self.display_current_image()
return
if not self.contour_edit_mode:
self.drag_start = (
(event.x - self.image_offset[0]) / self.display_scale,
(event.y - self.image_offset[1]) / self.display_scale
)
def on_canvas_drag(self, event):
if self.original_image is None:
return
if self.contour_edit_mode and self.edit_points:
x = (event.x - self.image_offset[0]) / self.display_scale
y = (event.y - self.image_offset[1]) / self.display_scale
self.edit_points.append((x, y))
self.display_current_image()
return
if self.drag_start and not self.contour_edit_mode:
x = (event.x - self.image_offset[0]) / self.display_scale
y = (event.y - self.image_offset[1]) / self.display_scale
x1, y1 = self.drag_start
self.temp_box = (min(x1, x), min(y1, y), max(x1, x), max(y1, y))
self.display_current_image()
def on_canvas_release(self, event):
if self.contour_edit_mode and self.edit_points:
self.apply_contour_edit()
self.edit_points = []
# 編集モードは継続(リセットしない)
self.display_current_image()
return
if self.drag_start and self.temp_box and not self.contour_edit_mode:
x1, y1, x2, y2 = self.temp_box
if abs(x2 - x1) > 20 and abs(y2 - y1) > 20:
self.face_boxes.append(self.temp_box)
self.drag_start = None
self.temp_box = None
self.display_current_image()
def main():
try:
from tkinterdnd2 import TkinterDnD
root = TkinterDnD.Tk()
except ImportError:
root = tk.Tk()
app = FaceBeautyApp(root)
root.mainloop()
if __name__ == "__main__":
main()

