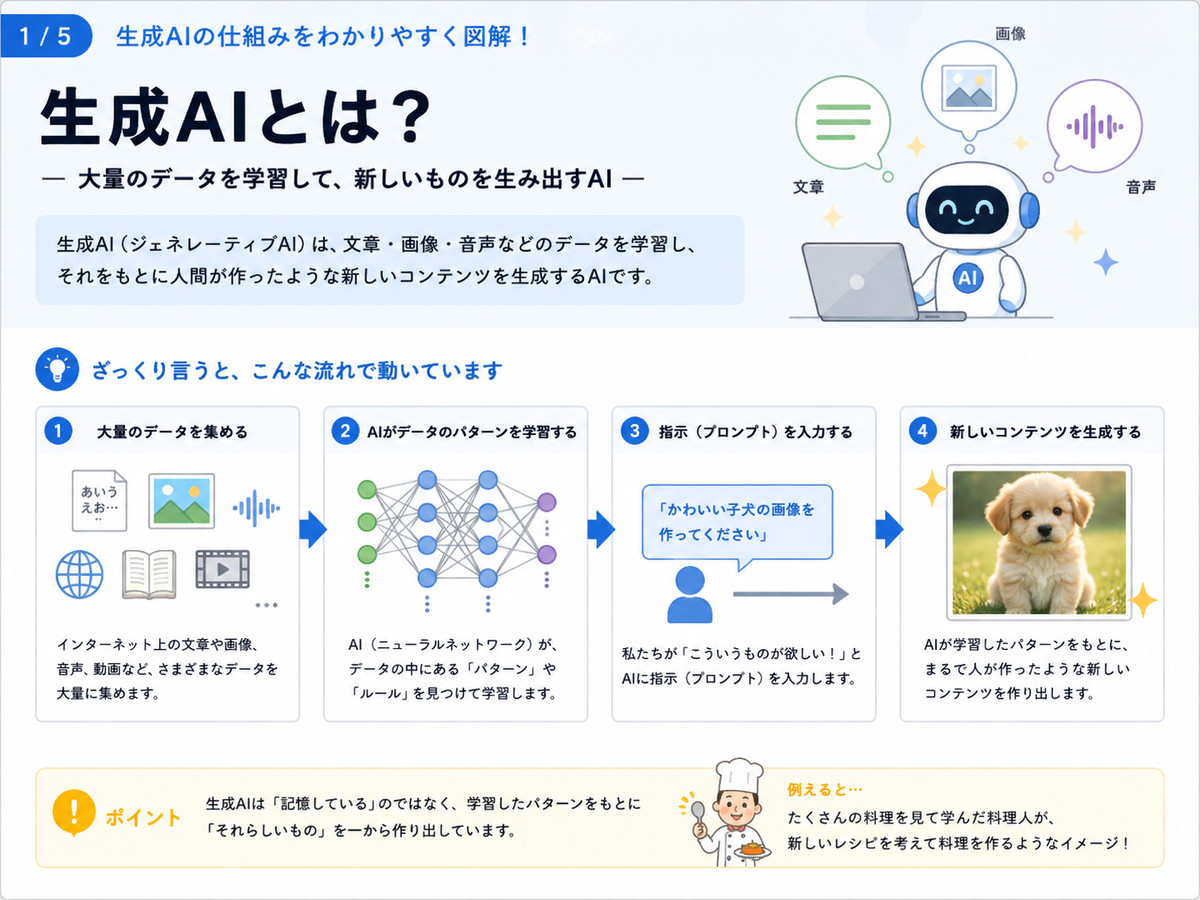
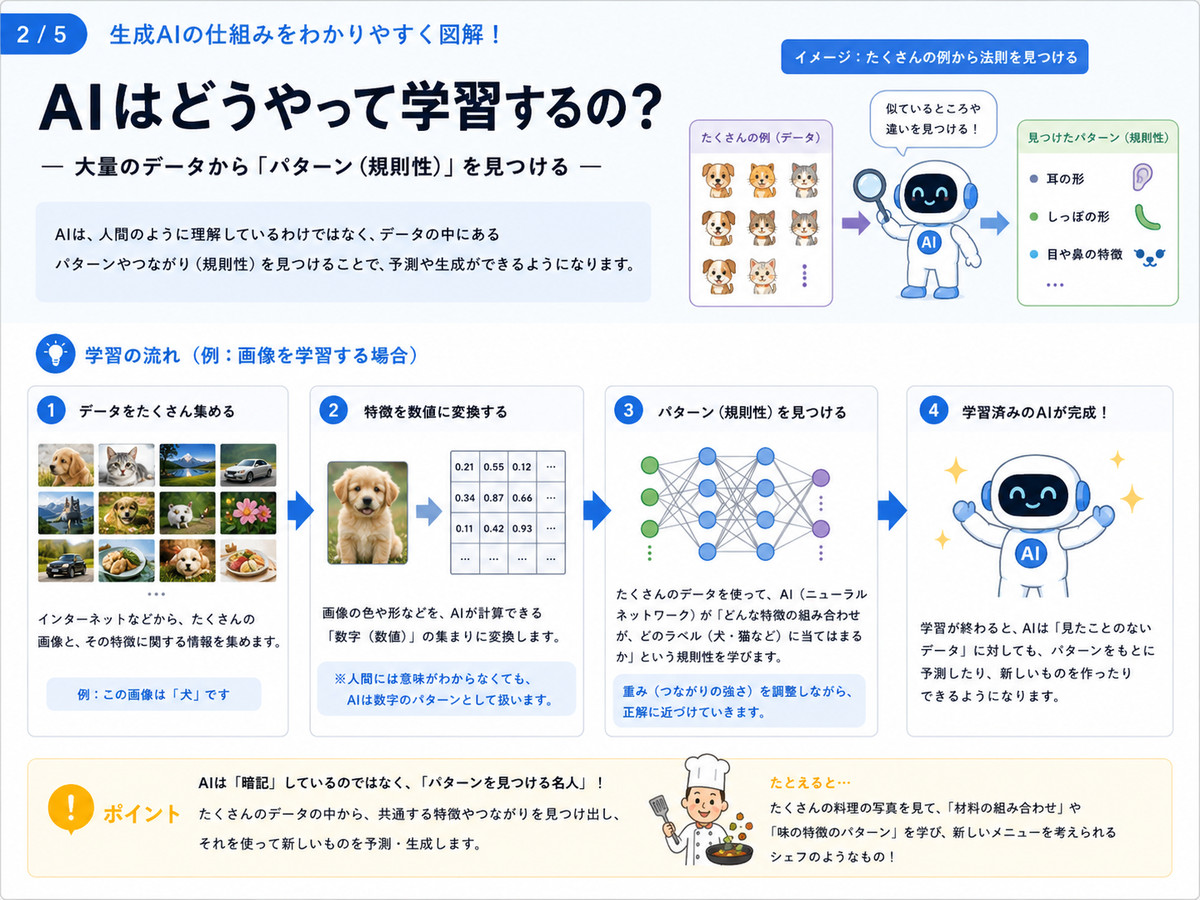
生成AIの仕組みをChatGPTで簡潔に図解。生成AIの技術の公開状況についてもChatGPTに聞いた。
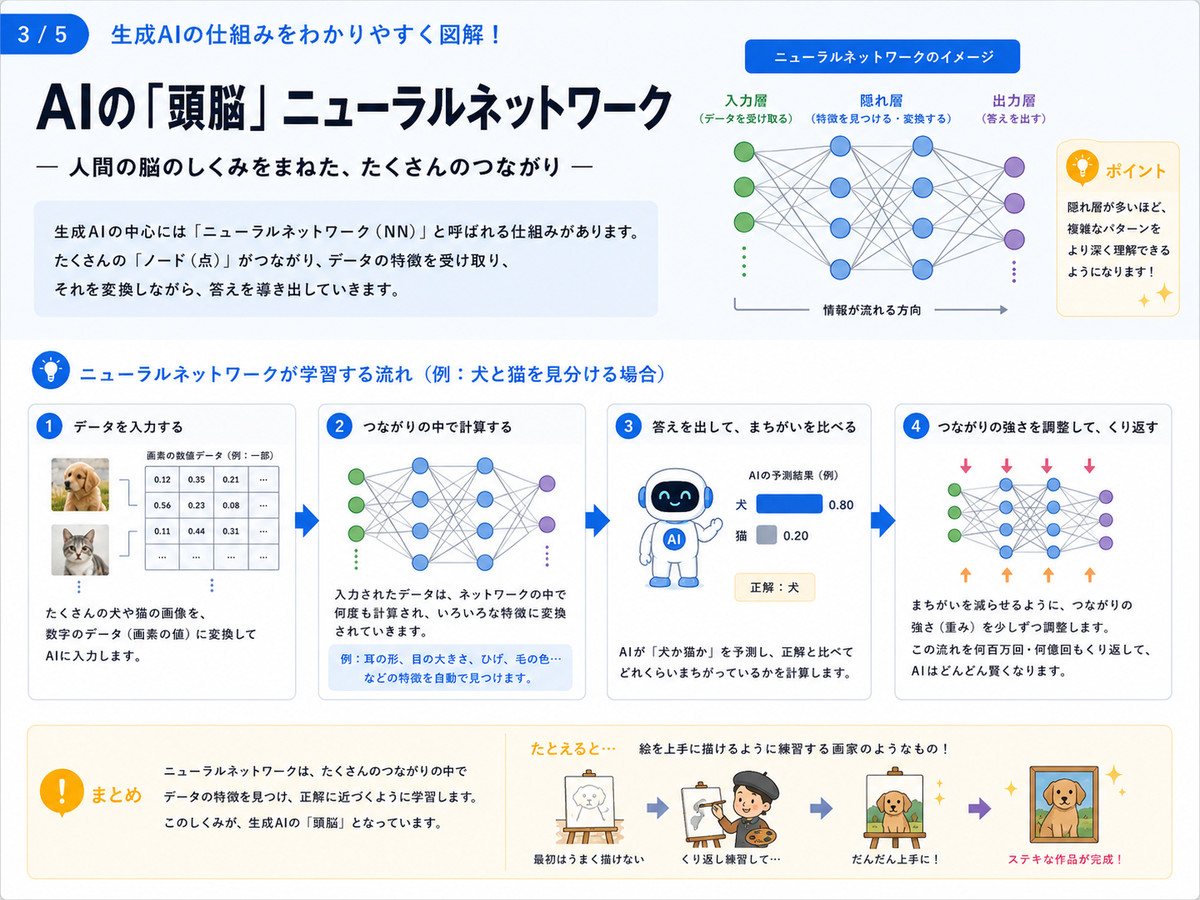
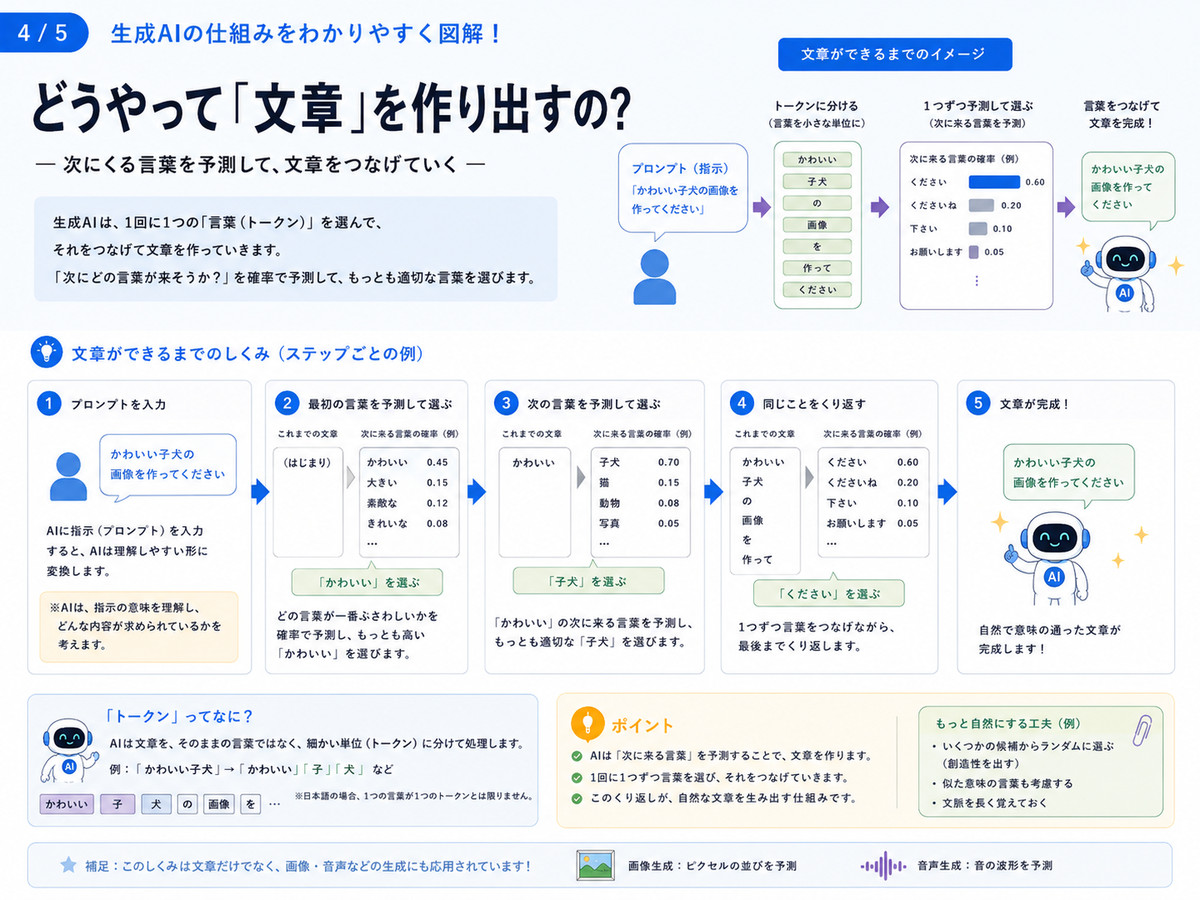
生成AIは、インターネット上の膨大なテキストや画像などのデータを事前に学習して「言葉のつながり」や「画風のパターン」を確率として捉え、ユーザーからの指示(プロンプト)に応じて、次に続く最も自然な確率の高いデータ(文字やピクセル)を次々と予測・選択しながら組み合わせることで、全く新しいコンテンツを自動で作り出す。
やっていることの根本は驚くほどシンプル。
一言で言えば、生成AIの基本は「超高度な『次に続く言葉(または画素)』の予測ゲーム」。
やっていることの基本(=確率に基づく次のデータの予測)はシンプルだが、以下の2つの桁違いなスケールによって、まるで人間が考えているように見えている。
- 膨大な記憶量(データ):地球上の本やウェブサイトをほぼ丸暗記している。
- 視野の広さ(文脈の理解):直前の1単語だけでなく、数千〜数万文字前の文脈まで同時に見失わずに計算できる。
「自ら考えて新しいアイデアを生み出している」というよりは、「膨大なデータの中から、最もそれっぽい組み合わせを確率的に再現している」というのが、この技術のシンプルな正体。
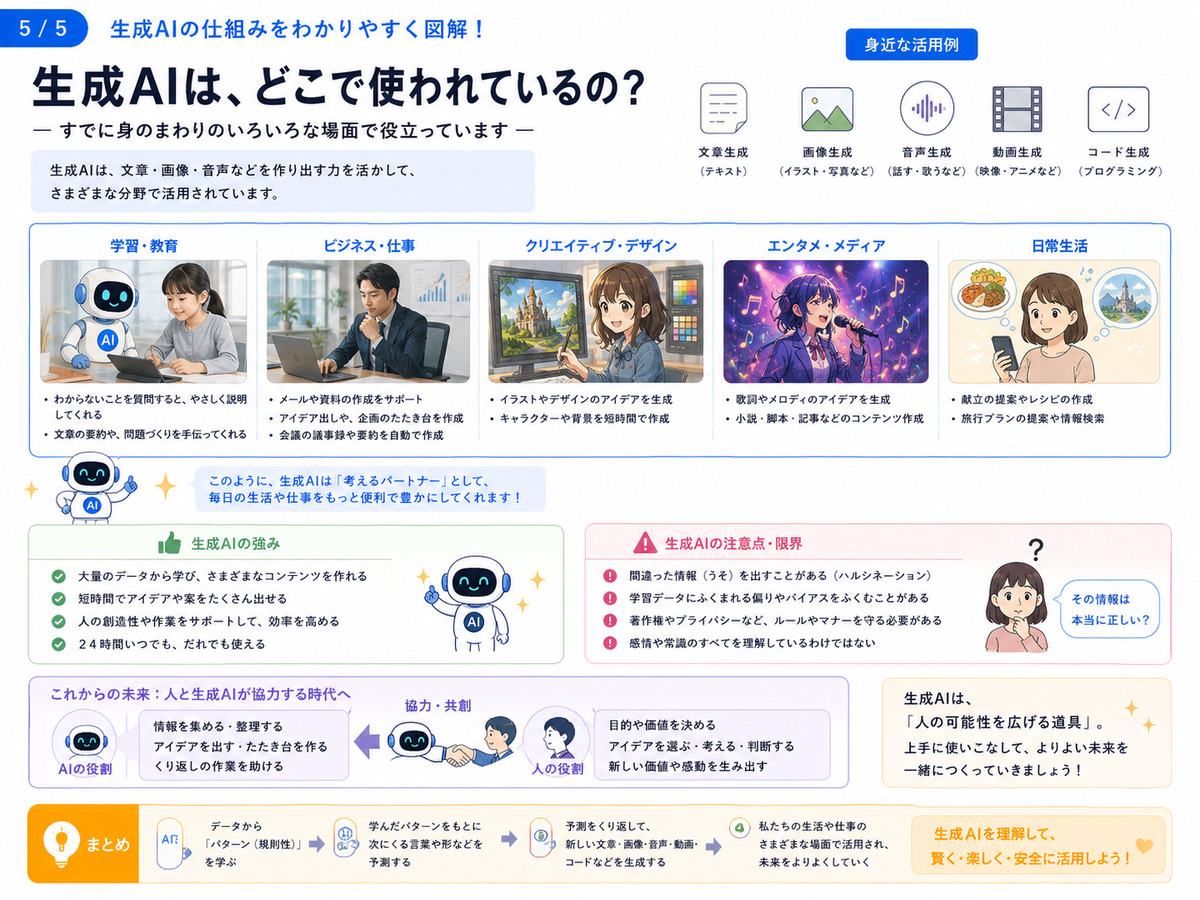
今更ながら、生成AIの仕組みをChatGPTに簡潔に図解してもらった。
内容が重複しているように感じるけど。
生成AIの技術の公開状況について、ChatGPTに聞いてみた。
生成AIの技術はどこまで公開されているのか
生成AIは近年急速に発展していますが、その技術のすべてが秘密というわけではありません。 実際には、生成AIを支える基本技術の多くは論文やオープンソースソフトウェアとして公開されています。 ただし、最先端の性能を実現するためのノウハウや学習済みモデルの詳細については、企業秘密として扱われている部分も少なくありません。
理論はほぼ公開されている
現在の生成AIの中核技術は、大学や研究機関による研究成果として公開されています。 代表的なものとして、Transformerアーキテクチャ、Attention機構、Diffusion Model(拡散モデル)、大規模言語モデル(LLM)などがあります。
これらの技術は学術論文として発表されており、研究者や開発者であれば誰でも内容を学ぶことができます。 現在の生成AIブームの基礎となった技術の多くは、公開された研究成果の上に成り立っています。
実装方法も広く公開されている
生成AIを実際に動かすためのソフトウェアやプログラムも、多くがオープンソースとして公開されています。
代表的な機械学習フレームワークには以下のようなものがあります。
- PyTorch
- TensorFlow
- Hugging Face Transformers
これらを利用すれば、小規模な生成AIであれば個人でも開発できます。 実際に、教育用として数百行から数千行程度のコードで動作する「ミニGPT」を作成する例も多数公開されています。
学習済みモデルは公開と非公開が混在している
生成AIの中核となる学習済みモデルについては、公開されているものと非公開のものがあります。
公開されている主なモデル
- Llama
- Mistral
- Qwen
これらは研究や商用利用が可能な形で公開されており、個人や企業が独自のAIシステムを構築するために利用できます。
非公開の主なモデル
- GPTシリーズ
- Geminiシリーズの一部
- Claudeシリーズ
これらのモデルでは、学習済み重みや詳細な学習手法が公開されていません。 利用者はAPIやサービスとして利用できますが、内部構造のすべてを知ることはできません。
本当に重要な部分は企業秘密
現在の生成AI開発において最も価値があるのは、基本理論そのものではありません。
- 学習データの収集方法
- データの選別やクリーニング技術
- 人間による評価データの作成
- 学習時のパラメータ調整
- 推論の高速化技術
- 大規模GPUクラスタの運用ノウハウ
これらのノウハウは論文だけでは再現が難しく、多くの企業が競争力の源泉として非公開にしています。
なぜ同じ技術でも性能に差が出るのか
生成AIの基本技術は世界中の研究者や企業が知っています。 しかし、どのようなデータで学習させるか、どのような手法で品質を向上させるかによって性能は大きく変わります。
これは飛行機に例えると分かりやすいでしょう。 空気力学の理論や基本的な設計原理は公開されていますが、最新鋭旅客機を製造するための製造技術や運用ノウハウは企業秘密です。 生成AIも同様に、基礎技術は公開されていても、最高性能を実現するための詳細なノウハウは公開されていません。
まとめ
生成AIの理論や基本的な実装方法は広く公開されています。 そのため、個人でも生成AIを開発することは可能です。
一方で、ChatGPTのような最先端モデルを実現するために必要な大規模データ、膨大な計算資源、品質向上のためのノウハウについては、多くが企業秘密となっています。
つまり、生成AIの「仕組み」は公開されている一方で、「最高性能を実現する方法」の多くは公開されていないと言えるでしょう。